
movielens-recsys:从 YouTube DNN 召回到 DCNv2 排序
电影推荐需要把用户过去的评分,转化为下一次打开页面时看到的电影列表。movielens-recsys 使用 MovieLens-1M 完成这条流程:输入用户编号和推荐时间,从电影目录中生成候选,最终展示 20 部电影。
项目使用 YouTube DNN 学习用户和电影的向量,再使用 DCNv2 判断候选的展示次序。数据划分、历史构造、其他召回通道和展示规则共同影响最终结果。理解这几个部分的连接方式,也能解释一部电影为何进入推荐列表。
项目仓库:Jackknifer/movielens-recsys。本文对应代码版本 78e2c98,使用 Python 3.11、TensorFlow 2.15、TensorFlow Recommenders、pandas 和 scikit-learn。文中的完整模型记录与测试集结果,于 2026 年 10 月 11 日核对。
项目目标与推荐流程
项目处理两个相互连接的问题。召回阶段从电影目录中生成候选,排序阶段判断候选的展示次序。最终列表还要满足类型与年代的连续数量限制。
一条推荐请求包含 user_id 和 as_of_timestamp。程序读取用户属性,并取出推荐时间之前及该时间点的交互。请求中的用户需要存在于用户属性表中;程序允许这个用户没有可用历史。
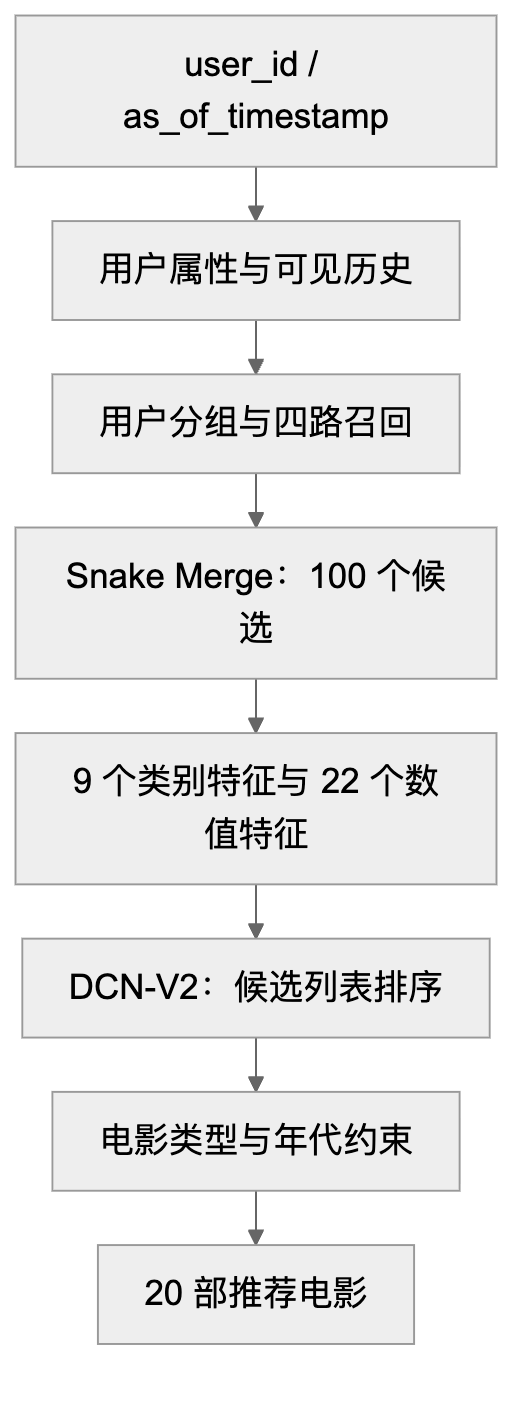
流程图根据项目源码使用 Mermaid 绘制。
| 阶段 | 输入 | 输出 |
|---|---|---|
| 用户上下文 | 用户编号、推荐时间、属性和历史 | 喜欢的电影、全部已看电影、历史数量和用户分组 |
| 多路召回 | 用户上下文、模型和索引 | 每路最多 100 个候选及其分数、排名 |
| 候选合并 | 四路候选 | 最多 100 部互不重复的电影及全部来源 |
| 排序 | 候选属性与上下文特征 | DCNv2 分数和候选排名 |
| 重排 | 排序列表、电影类型和年代 | 满足展示限制的前 20 部电影 |
| 评估 | 各阶段列表与保留评分 | 命中、排名、覆盖率、多样性及来源统计 |
这个结构把候选生成能力、候选排序能力和展示规则分别变成可检查的结果。若目标电影没有进入 100 个候选,排序阶段就无法将它提升到前 20 位。
两个模型承担不同的计算任务。YouTube DNN 可以提前计算目录电影向量,请求到来时只计算用户向量和内积。DCNv2 则为每个用户电影组合计算特征交叉,并使用这次请求的召回排名、来源和兴趣特征。将 DCNv2 的计算范围限制为 100 部候选,可以减少逐部评分的数量。
MovieLens 提供用户主动留下的评分。本文将至少 4 分定义为相关目标,学习高评分电影的推荐次序。数据没有曝光、点击和观看时长,因此文中的效果指标衡量保留评分的命中能力,尚无法表达实际点击率或观看收益。
对应入口:run_pipeline.py。recommend_from_bundle() 连接全部推荐阶段,save_recommendation_run() 保存结果。
数据与历史:模型能看到哪些信息
三张数据表与数据准备
项目读取 users.pkl、movies.pkl 和 ratings.pkl。评分来自 MovieLens-1M,电影表包含 FunRec 整理的补充属性。
| 数据表 | 核心字段 | 用途 |
|---|---|---|
| users | user_id、gender、age、occupation、zip_code |
用户属性与模型输入 |
| movies | movie_id、genres、isAdult、startYear |
电影特征、类型兴趣和重排 |
| ratings | user_id、movie_id、rating、timestamp |
历史、训练目标与评估标签 |
数据准备需要统一评分含义。FunRec 文件使用 2、4、6、8、10 分,项目除以 2,转换为 MovieLens 的 1~5 分。随后读取 GroupLens 官方 ZIP,逐条比较用户、电影、评分和时间戳。评分范围与时间字段的定义参见 MovieLens-1M 官方说明。
isAdult 和 startYear 中的缺失值保存为 __MISSING__。缺失属性作为独立类别参与编码,原有电影和评分继续保留。
load_movielens() 检查字段、空值、编号、评分范围和引用关系。用户编号、电影编号必须唯一,评分中的用户电影组合也必须唯一。连接属性表时使用 many_to_one 校验,防止重复属性记录增加样本数量。
准备后的数据规模如下。
| 项目 | 数量 |
|---|---|
| 用户 | 6,040 |
| 电影属性记录 | 3,883 |
| 评分 | 1,000,209 |
| train | 988,129 |
| validation | 6,040 |
| test | 6,040 |
| cold_start 划分 | 0 |
下载脚本记录并检查数据摘要。准备脚本核对评分内容,加载模块核对数据结构。这些检查分别回答来源、内容和输入是否符合项目要求。
对应代码:prepare.py、load.py和 feature_join.py。
按用户时间划分与历史前缀
split_by_user_time() 对每位用户按交互时间排序。最后一条评分进入 test,倒数第二条进入 validation,其余进入 train。相同时间戳使用原始输入位置确定顺序,保证重复执行时使用相同规则。
交互少于 3 条的用户,全部记录进入 cold_start。MovieLens-1M 的本次数据中,这个集合为空。推荐流程仍然支持用户在某个推荐时间没有历史,数据划分中的数量与请求时的分组需要分别理解。
训练历史使用前缀构造。对当前电影生成样本时,先保存此前喜欢的电影,再处理当前电影。评分达到 4 分的电影才加入喜欢历史,因此训练目标不会进入自己的历史。
推荐时需要同时保存两份记录。hist_movie_id 包含最近最多 10 部高评分电影,供模型和兴趣计算使用;seen_movie_ids 包含推荐时间可见的全部已看电影,供召回排除。低评分电影也进入已看集合。
history_length 保存可见的全部高评分交互数量。它可以超过 10;截取后的序列长度用于模型输入,完整数量用于用户分组和排序特征。
时间规则覆盖每位用户自己的交互顺序。不同用户的训练记录仍可能跨越其他用户的测试时间。严格研究全站某个时间点的推荐效果,需要另设全局时间划分及对应的候选可用规则。
对应代码:split.py、user_history.py和 user_context.py。
类别编码与未知值
类别编码器只使用训练阶段可见的数据建立词表。验证和推荐继续使用这些编码器,保持同一个值在不同阶段的编号一致。
| 编号 | 含义 |
|---|---|
| 0 | padding(序列补齐) |
| 1 | 训练词表以外的未知类别 |
| 2 及以上 | 训练词表中的已知类别 |
OrdinalEncoder 的未知值为 -1,已知值从 0 开始。encode_category() 统一加 2,得到上述编号。历史序列左侧补 0,超长时保留最近的 10 条记录。
年龄、职业、邮政编码和发行年份在当前排序模型中都作为类别字段。编号表达类别身份,Embedding(向量表示)学习其关系,编号大小本身没有评分含义。
对应代码:encode.py。
多路召回:从电影目录生成候选
YouTube DNN:把用户历史变成检索向量
YouTube DNN 来自 Covington 等人的推荐系统论文。本文采用其中候选生成的思路:从用户属性和历史学习一个向量,再通过向量相似度找到电影。项目中的字段、维度和归一化规则,均由 MovieLens 的实际实现确定。论文见参考文献 [1]。
训练样本表达“已有喜欢历史,接下来喜欢哪部电影”。build_retrieval_samples() 只选择评分达到 4 分、且此前已有喜欢历史的目标。目标电影单独作为标签,用户模型接收目标之前的属性与历史。
用户输入包含 user_id、gender、age、occupation 和 zip_code,以及 hist_movie_id 和 hist_genres 两组历史。类别编号用于查询 Embedding 中的向量。每个类别字段产生 16 维向量,历史最多保留最近 10 部高评分电影。
历史电影和历史类型分别做 Masked Mean Pooling(排除补齐位置的平均聚合)。设序列位置 的编号为 ,对应向量为 ,有效位置标记为 ,则:
编号 0 的位置同时从分子和分母中排除。模型将电影历史聚合为 16 维向量,将类型历史也聚合为 16 维向量。类型历史取每部电影的第一个类型,顺序与电影历史一致。
平均聚合保留这组历史的总体兴趣。同一组历史互换位置后,平均结果保持相同;最近 10 部电影的选择决定哪些交互进入模型。这一性质有助于理解历史长度和兴趣更新如何影响检索。
平均聚合也决定了梯度如何进入历史向量。设有效历史有 个位置,上游梯度为 ,则有效位置获得相同份额:
同一电影重复出现时,其 Embedding 累加各位置的梯度。sum pooling(求和聚合)会使表示的尺度随历史数量变化;max pooling(逐维最大值聚合)只将各维梯度传给取得最大值的位置。当前平均聚合对有效位置均分贡献,序列补齐位置的贡献为 0。
这个用户向量也独立于当前待评分的候选。每次请求可以复用它检索全部电影。候选相关的历史关注程度,由排序阶段的相似度和类型兴趣特征进一步表达。
5 个属性向量与两组历史向量连接后,输入维度为 。记连接结果为 ,用户网络的计算为:
两层 ReLU(保留正值、将负值置零的激活函数)分别输出 64 维和 32 维。最后一层是 16 维线性层,随后进行 L2 归一化。用户模型最终输出一个 L2 范数为 1 的 16 维向量。
电影模型查询 movie_embedding,得到电影 的向量,再归一化:
用户历史与候选电影共用同一个 movie_embedding。历史聚合读取其中的原始向量,电影输出使用归一化后的向量。训练同时更新用户网络和电影向量,让真实高评分目标与对应用户具有较高的相似度。
由于两个输出向量均已归一化,内积 等于余弦相似度。模型把用户和电影映射到同一空间,推荐阶段就能通过矩阵乘法计算整份目录的相似度。
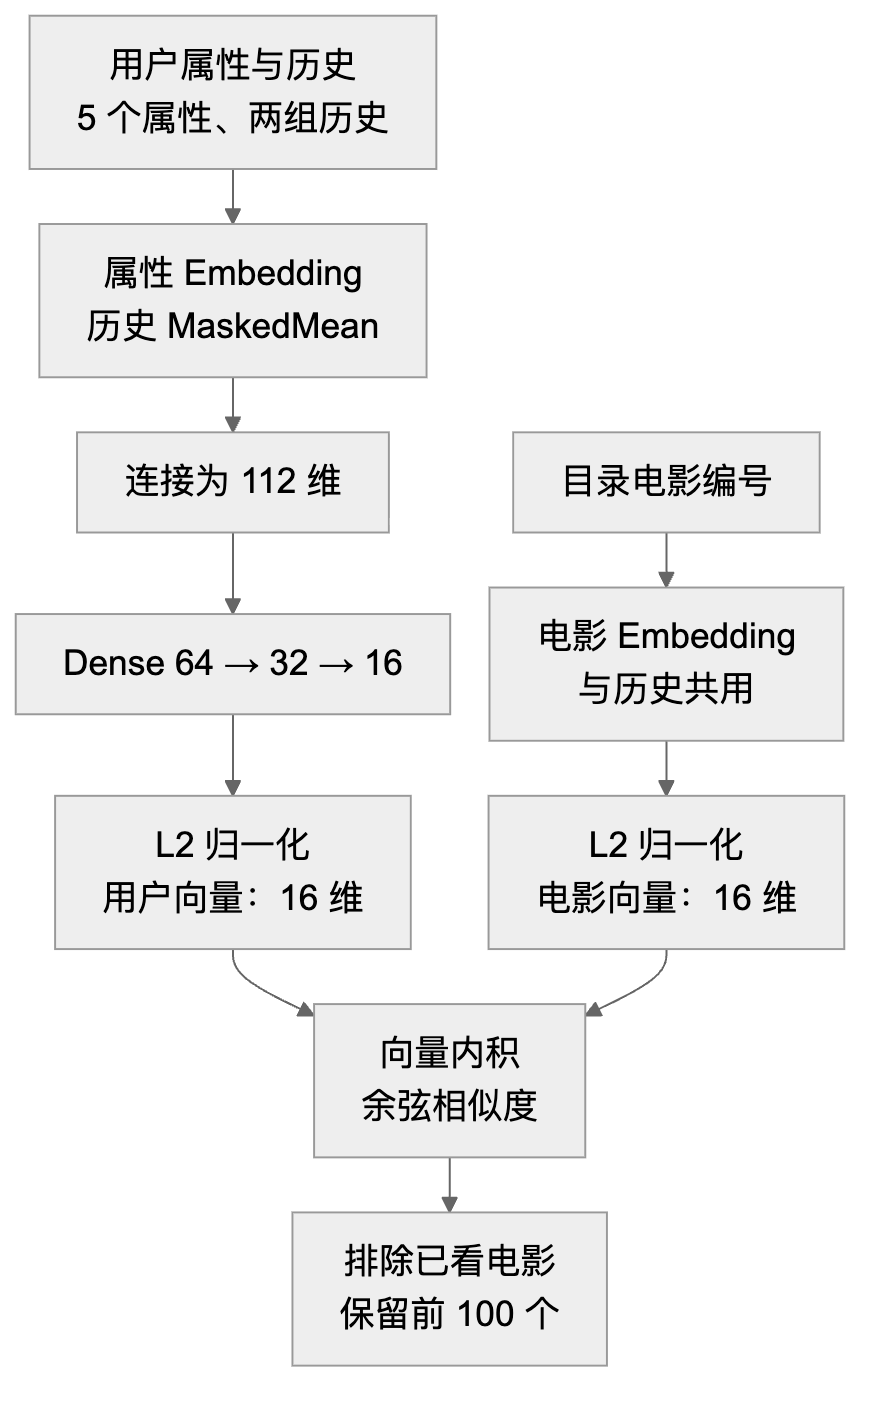
YouTube DNN 的输入、共享电影向量和检索过程,根据项目源码使用 Mermaid 绘制。
对应代码:youtubednn.py和 retrieval_inputs.py。
用 sampled softmax 训练召回模型
召回训练把下一部高评分电影当作分类目标。设召回电影目录为 ,温度参数为 ,真实目标为 。完整 softmax(将类别得分归一化的函数)对应:
这个目标要求真实电影相对于其他电影获得较高得分。分母包含整份训练电影目录,目录扩大时,逐次计算全部类别的成本也会增加。
项目使用 tf.nn.sampled_softmax_loss() 计算 sampled softmax(通过采样类别计算的训练损失)。每个 batch(批次)采样 20 个电影类别;TensorFlow 默认执行 log-uniform(按类别编号的对数均匀分布)采样,并处理采样类别与真实目标重复的情况。
设电影类别总数为 ,采样编号为 ,采样器的基础分布为:
较小编号具有较高的采样概率。当前词表按电影编号排列,这份分布表达编号的采样概率。电影热门程度另由训练高评分次数统计。分布定义与预期次数的说明见 TensorFlow log_uniform_candidate_sampler。
采样损失还会修正不同类别的采样频率。设采样器返回的预期采样次数为 ,修正后的得分为 。记排除当前真实目标后的采样集合为 ,每条训练样本的损失可写为:
对真实目标和采样类别分别由采样器计算。它参与训练中的频率修正,实际计算由 TensorFlow 完成。接口与采样说明见 TensorFlow sampled_softmax_loss。
代码把电影编码减去 2,转换为损失函数要求的类别编号。padding 和未知编号因此不参与目标类别采样。采样电影承担类别区分的作用;这些电影是否符合该用户的真实兴趣,仍需要交互数据判断。
训练中的负例需要连同来源一起理解。
| 来源 | 所表达的信息 | 项目中的使用位置 |
|---|---|---|
| 目录类别采样 | 训练中与当前目标竞争的电影类别,可能包含用户喜欢的其他电影 | YouTube DNN 的 sampled softmax |
| Batch 内其他目标 | 复用同批其他样本的目标,需要处理重复目标和采样分布 | 用于理解另一种常见召回训练方式 |
| 明确低评分 | 用户已经评价,且评分至多 2 分 | 排序样本类型与二分类评估 |
| 目标窗口中的其他候选 | 窗口内没有观察到高评分,真实兴趣可能未知 | DCNv2 列表损失的分母 |
Batch 内采样可以复用已计算的目标向量,构造 的得分矩阵。仅比较内积计算,其成本为 ;共用 个目录采样类别时,相应成本约为 。两种方法的计算量需要结合批次大小和采样数量判断,当前 、、。
未观察到交互的电影可能是用户尚未接触的内容,将它用于训练会引入假负例。曝光后未点击的电影也只能表达某次展示没有发生点击。MovieLens 没有曝光日志,当前标签无法提供这类展示证据。
本项目设置 ,在训练得分中放大向量相似度的差别。每批默认使用 128 条样本,损失按样本取平均,再使用 Adam(自适应梯度优化方法)更新参数。学习率为 0.001,召回模型默认训练 3 轮。
较小的温度会使相同相似度差值在 softmax 中产生更大的概率差异,梯度也受到 的缩放。电影向量维度决定表示容量,温度决定训练得分尺度,两者承担不同作用。当前维度和训练参数是这次完整模型的设置,效果优劣仍需要同一评估条件下的实验判断。
sampled softmax 用于训练阶段。训练损失可以反映同一训练过程的变化;实际推荐质量继续使用真实电影目录中的 Recall 和排名指标评估。
对应代码:train_retrieval.py。
将训练结果用于电影检索
训练完成后,程序保存用户模型、电影模型、类别编码器,以及目录电影的编号与向量。第 行电影向量必须对应 movie_ids[j],这份关系决定检索结果能否正确转换为电影编号。
推荐请求到来时,程序用相同编码器处理用户属性和当前历史,计算用户向量。设一个请求批次的用户向量组成矩阵 ,电影向量组成矩阵 ,则全部相似度为:
每行对应一位用户,每列对应一部目录电影。程序排除该用户全部已看电影,保留分数最高的 100 个候选;分数相同时按电影编号排列。当前检索计算完整目录,并按用户批次控制矩阵大小。
内积计算量为 ,得分矩阵占用 空间。电影向量预计算减少了请求时重复编码电影的工作,完整目录扫描仍然随电影数量增加。本文的 3,529 部电影使用完整内积检索,检索结果没有经过近似向量索引;目录规模与检索方式共同限定了当前工程结果的适用范围。
完整模型导出 3,529 部电影,来自召回训练的目标与历史词表。数据表中的 3,883 条电影属性记录,只有进入这份词表的电影拥有可检索向量。目标电影是否在目录中,会直接影响后面的候选覆盖率。
这里使用归一化向量的原始内积进行检索。固定的温度参数影响训练中的得分尺度;同一组向量除以相同正数后,候选的相对顺序保持相同。
对应代码:vector_recall.py。
物品相似、类型兴趣与热门电影
物品相似召回复用 YouTube DNN 学到的电影向量。索引为每部电影保存 50 个相似电影,排除电影自身。请求时取最近 3 部喜欢的电影,读取各自的近邻。
一个候选可能同时与多部历史电影相似。项目使用这些相似度的最大值作为该路得分,随后排除已看电影并排序。两条向量召回通道共享电影表示,其差别在于用户向量检索与历史电影近邻聚合。
类型兴趣召回使用电影的全部类型。每部历史电影贡献相同总权重,多种类型平分这份权重。设 为电影类型集合, 为最近喜欢历史,则用户对类型的权重为:
设 为电影在训练历史中的高评分次数。类型内部将高评分次数归一化,得到该电影在类型中的得分:
同一候选匹配多个类型时,贡献相加。热门召回直接按照训练历史中的高评分次数排列,负责为全部请求提供候选。
这些统计只使用传入的训练历史,四路召回共享导出的电影目录。各路得分分别表达余弦相似度、类型贡献和高评分次数,单位与范围需要在后续特征中分别处理。
对应代码:item_similarity_recall.py、genre_recall.py和 popular_recall.py。
用户分组决定召回通道
用户是否能够使用模型召回,取决于历史数量和召回用户词表。默认 min_history=5。
| 分组 | 条件 | 启用通道 |
|---|---|---|
no_history |
没有高评分历史 | 热门 |
short_history |
词表中用户有 1~4 条高评分历史 | 类型兴趣、热门 |
unseen_user |
存在高评分历史,用户超出召回词表 | 类型兴趣、热门 |
warm |
用户在召回词表中,且至少有 5 条高评分历史 | 全部四路 |
“有用户属性”与“在召回词表中”是两个条件。属性表中的用户可能没有进入召回训练样本,此时仍然可以请求推荐,并由上述规则选择通道。
用户历史不足和新电影需要分别处理。上述分组决定用户使用哪些召回通道。新电影若没有进入导出的电影词表,就没有已训练的检索向量;四路通道共用该目录,因此类型和热门通道也受目录限制。类别编码中的未知编号使输入能够表达未知类别,电影进入候选仍然需要对应的目录记录。
对应代码:cold_start.py。
Snake Merge 保留候选来源
snake_merge() 按固定通道顺序往返访问候选列表,直到选出 100 部电影或全部候选用完。到达边界后改变方向,边界通道会连续得到两次访问机会。
已经选入的电影与全部已看电影都会跳过。候选首次被选入时,保存 candidate_rank;同时记录该电影在全部通道中的来源、分数和排名。
source 表示首次选入时的通道。sources、source_scores 和 source_ranks 保存全部提议来源,包括同一电影在其他通道中的记录。排序特征因此能够表达多路共同支持的候选。
这个合并过程使用各路排名组织访问顺序。不同通道的原始分数保留到后续特征中。通道顺序及候选预算会影响最终集合,需要连同模型设置一起记录。
对应代码:merge_recall.py。
排序:用 DCNv2 判断候选的展示次序
召回阶段已经为每位用户提供 100 部候选。候选中同时存在向量相似、类型匹配和热门电影,排序需要结合用户属性、电影属性与召回信息,判断哪些电影应当进入前 20 位。
项目使用 DCNv2(Deep & Cross Network v2,深度交叉网络)完成评分。它将显式特征交叉和 DNN(深度神经网络)连接在同一个模型中,训练时使用真实召回候选构造的列表。模型论文见参考文献 [2]。
从 train 内部构造历史与目标窗口
排序训练需要学习召回候选中的展示次序。build_candidate_training() 在每位用户的 train 内部进行时间划分:前 80% 构造历史,后 20% 构造目标窗口。切分位置按记录数量向下取整,并保留至少一条历史。
程序使用前段历史训练一套召回模型和索引,在这段历史的最后时间生成真实候选。后段评分只参与候选标签生成。排序训练标签来自 train 内部,validation 用于模型选择,test 用于最终评估。
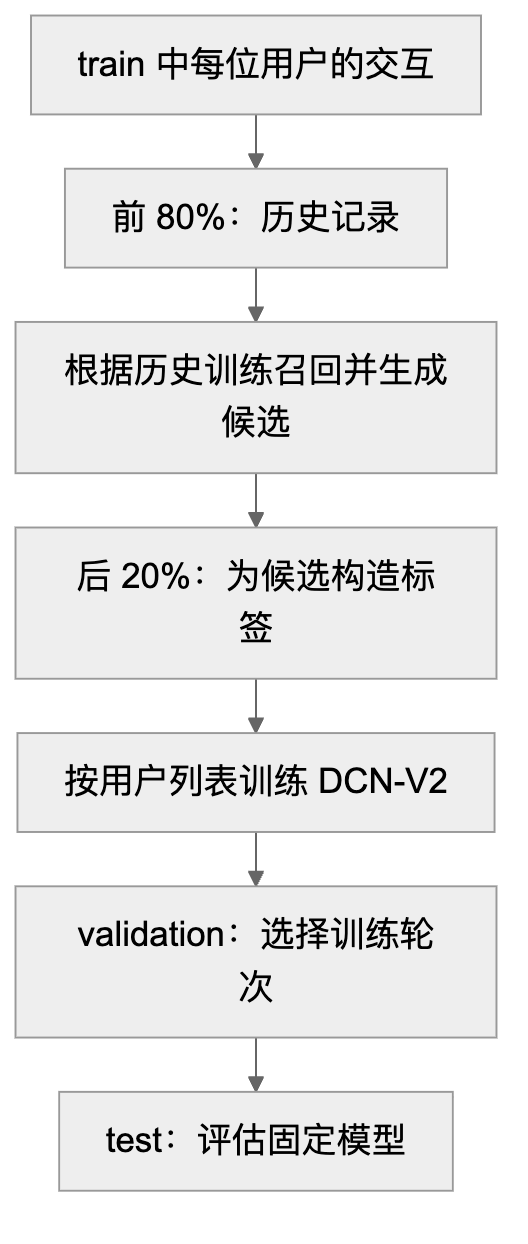
训练图根据 ranking_candidates.py 和 train_ranking.py 使用 Mermaid 绘制。
| sample_kind | 标签 | 具体含义 |
|---|---|---|
window_positive |
1 | 候选在目标窗口得到至少 4 分 |
window_low_rating |
0 | 候选在目标窗口得到至多 2 分 |
window_unobserved |
0 | 其余候选,包括窗口中的 3 分记录和窗口内未观察到评分的电影 |
标签 0 表达“目标窗口中没有观察到高评分”。窗口外的评分没有参与这次标签构造;未观察到评分的电影,其真实兴趣仍然未知。
这些候选来自实际召回列表,包含模型较容易混淆的电影。排序模型因此学习推荐流程中会遇到的候选关系。用大量随机未交互电影训练二分类模型时,训练样本的分布可能与这份候选列表不同;比较结果需要同时控制候选来源和标签规则。
若某位用户的候选完全没有高评分目标,这份列表无法提供当前损失需要的正例,程序会排除该列表并记录数量。本次完整模型的训练记录包含 6,040 个查询、604,000 个候选;其中 5,435 个查询提供高评分候选,最终使用 543,500 条排序样本。
保存的样本类型统计为:31,315 条 window_positive、4,250 条 window_low_rating 和 507,935 条 window_unobserved。被排除的 605 个查询应当与训练样本规模一起报告,便于理解训练人群。
当前排序训练只使用具有召回正例的列表。该训练范围适合学习已有目标的相对次序,也会改变训练人群。测试评估继续保留没有命中候选的高评分目标用户,才能同时看到候选缺失和排序的影响。
用于构造排序样本的召回模型只看到前段历史。最终推荐使用的召回模型可以看到完整 train,因此两者具有不同的训练范围和目录。项目保存排序训练的召回模型、历史和目标窗口,用于核对特征来源。
对应代码:ranking_candidates.py。
9 个类别字段与 22 个数值特征
排序模型对每个用户电影组合计算一个得分。类别输入包括 user_id、gender、age、occupation、zip_code,以及 movie_id、genres、isAdult 和 startYear。电影的 genres 在类别编码时取第一个类型,其余字段也使用类别编码。
另外 22 个数值特征描述召回来源、历史兴趣和候选关系。
| 特征组 | 数量 | 内容 |
|---|---|---|
| 每路召回信息 | 12 | 4 路各有 present、score 和 reciprocal_rank |
| 合并来源 | 2 | source_count、merge_reciprocal_rank |
| 用户兴趣 | 2 | log_history_length、genre_affinity |
| 向量相似度 | 3 | recent_mean_similarity、recent_max_similarity、last_movie_similarity |
| 电影热门程度 | 1 | log_popularity |
| 向量可用情况 | 2 | retrieval_known_item、history_vector_coverage |
present 标记某路是否提议了候选,倒数排名表达靠前程度。缺少该路提议时,相关特征填 0,present 保留了“未出现”的含义。热门次数先使用 log1p(),降低计数跨度。
向量相似度计算候选与最近喜欢历史的关系。电影超出向量目录时,相似度特征为 0,并通过 retrieval_known_item 标记是否有向量。history_vector_coverage 记录历史中拥有向量的比例。
数值特征使用只在排序训练样本上拟合的 StandardScaler。设第 个特征值为 ,保存的均值和尺度为 、,标准化后的值为:
尺度来自训练数据中的标准差;常量特征的保存尺度为 1。验证和推荐复用相同均值、尺度和字段顺序,各阶段因此具有相同的特征含义。
9 个类别字段各产生 16 维向量,共 144 维。记它们为 ,再连接 22 个标准化数值特征,得到:
这里的分号表示向量连接。类别向量表示用户与电影的身份和属性,数值特征描述这次请求中候选与历史、召回通道之间的关系。
特征连接保存各字段的信息,随后由 Cross 中的乘法产生显式交互。单独的线性层只会计算各输入的加权和;例如“某类用户对某类电影的兴趣”,需要能够表达两个字段共同作用的函数。DNN 使用非线性激活学习这样的函数,Cross 直接构造坐标乘积,两路共同参与最终评分。
对应代码:ranking_features.py和 ranking_inputs.py。
Cross Network 如何产生特征交叉
DCNv2 使用并行结构。Cross Network(特征交叉网络)和 DNN 读取同一个 166 维输入,两路各自计算后连接。Cross 分支在每层显式构造原始特征与当前表示之间的乘积。
本项目的 Cross Network 有 3 层,每层保持 166 维。用列向量表示时,第 层的计算为:
是原始输入, 是当前层表示, 表示逐元素相乘。 是完整权重矩阵, 是可学习的加性参数。末尾的 是残差连接,使上一层表示继续参与输出。
第一层中,。展开输出的第 个分量,可以看到交叉项来自哪里:
最后一项包含 ,即两个输入维度的乘积。相应权重由训练学习。模型可以由此表达用户属性与电影属性、历史兴趣与召回得分等特征之间的组合关系。
每增加一层,当前表示又与 相乘,最高多项式阶数增加 1。3 层 Cross 可以产生最高 4 阶的显式交互。同一字段的多个向量维度也可以参与交互,这里的阶数按输入向量坐标计算。
每层权重矩阵有 个参数,加性向量有 166 个参数。3 层 Cross 共包含 83,166 个参数,输出仍为 166 维。这些数量只统计 Cross 分支。
实现使用 TensorFlow Recommenders 的 Cross,设置 projection_dim=None。默认 diag_scale=0,Cross 内部的线性变换直接对应上述公式。具体实现见 TFRS 0.7.3 Cross 源码。
完整矩阵使每个输出坐标都能学习自己的一组交互权重。若约束 ,所有行共用同一组参数,乘法部分就变成 。DCNv2 扩展了原始 DCN 中这种共用标量的交叉表达能力。
论文还研究了低秩矩阵分解。用 表示矩阵,可以计算:
每层矩阵参数由 变为 ,当 时可以减少参数和乘法。项目使用完整 矩阵,论文中的低秩分解与多专家结构属于模型家族中的其他结构。完整矩阵、层数和输入维度共同决定当前 Cross 的容量与计算量。推导见参考文献 [2]。
DNN 分支与最终排序得分
DNN 分支也从 开始,通过两层非线性变换学习特征组合。设 表示比例为 的 Dropout(训练时随机停用部分单元),则:
两层分别输出 64 维和 32 维。训练时,Dropout 按 0.1 的比例随机停用单元,并缩放保留的输出;预测时,这个操作保持输入不变。它帮助控制训练过程中的过拟合。
ReLU 使两层网络具有非线性表达能力。连续线性变换可以合并成一次线性变换;加入 ReLU 后,网络可以根据输入区间学习不同关系。Dropout 则让训练不能持续依赖同一组单元,保留单元按 缩放,使输出的期望尺度保持相同。
Cross 输出 ,DNN 输出 。两个结果连接为 198 维向量,再经过一层线性评分:
每个用户电影组合得到一个 ,对应代码中的 ranking_logit。当前模型保留原始得分,得分大小用于排列候选次序,尚未校准为点击概率或用户喜欢概率。
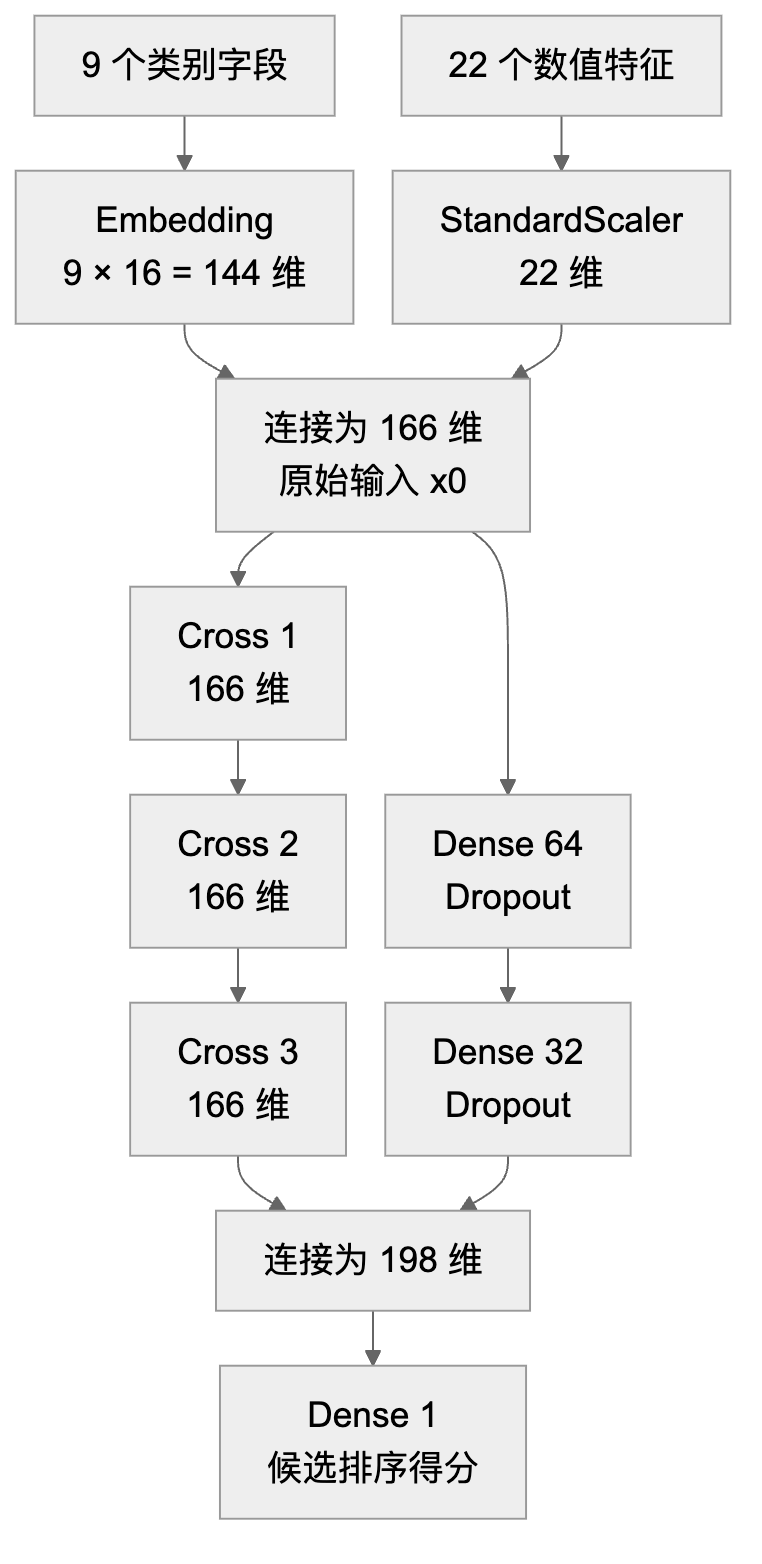
DCNv2 的并行结构根据 build_dcnv2() 使用 Mermaid 绘制。每层 Cross 都接收原始输入与上一层表示。
源码中的数据形状可按下表核对。
| 位置 | 每条候选的维度 | 代码位置 |
|---|---|---|
| 类别向量连接 | 144 | categorical_features |
| 加入数值上下文 | 166 | base_features |
| 3 层 Cross 输出 | 166 | cross_2 |
| DNN 输出 | 32 | dropout_1 |
| 两路连接 | 198 | combined_features |
| 线性评分 | 1 | ranking_logit |
推荐时,score_candidates() 为这 100 部电影连接属性与上下文,使用相同编码器和标准化参数,再调用模型。predict_records() 按批次预测,最终按用户、分数和电影编号排列,得到送入重排的候选列表。
对应代码:dcnv2.py和 ranking_predict.py。
DeepFM 中的二阶交互与共享向量
仓库中的 DeepFM(深度因子分解机)用于类别特征二分类基线。它为 9 个字段分别查询 16 维向量,FM(因子分解机)和 DNN 共用这些向量,一阶项单独查询每个类别的标量权重。
设 、, 表示字段 的第 维向量值,FM 二阶项为:
平方展开后,每对不同字段出现两次;减去各字段自身的平方,再除以 2,就得到字段之间的内积之和。FactorizationMachine.call() 直接使用等式右侧,将逐对计算的 成本降为 。
向量共享使一个类别从多种交互中获得训练信号。即使两个类别很少共同出现,它们的向量也可以通过其他组合得到更新,进而计算这对类别的交互。FM 显式计算二阶项,DNN 读取向量连接并使用 64 维、32 维隐藏层,学习非线性组合。
设一阶项为 ,DNN 输出为 ,当前实现的输出为:
相关二分类工具把高评分记录标为 1,低评分记录标为 0。sample_unobserved() 还可以从训练目录中选择未交互电影,默认每个高评分记录对应一个采样负例,并保存 unobserved 标记。未交互标签的含义需要连同采样假设保留。
本文的完整流程使用含 22 个上下文特征的 listwise DCNv2。现有测试结果没有提供 DeepFM 与 DCNv2 在相同输入、候选和损失下的效果比较,模型结构的表达能力与本次排序收益需要分别理解。DeepFM 原理见参考文献 [7]。
对应代码:deepfm.py、ranking_samples.py和 negative_sampling.py。
按用户列表计算训练损失
训练损失决定模型学习得分的哪种性质。Pointwise(逐条样本训练)使用一条用户电影记录,例如以 预测二分类标签 ,交叉熵及其对得分的梯度为:
Pairwise(按样本对训练)关注同一用户的两个候选。例如令高评分目标得分为 ,另一候选得分为 ,BPR(贝叶斯个性化排序)形式的单对损失为:
这项损失推动正例超过配对候选,两项得分同时增加相同常数时,损失保持相同。配对方式与采样对象决定模型会学习哪些相对关系。BPR 的完整目标还包括正则化,原始论文见参考文献 [8]。
当前 DCNv2 使用 Listwise(按候选列表训练),在同一用户的完整候选中分配目标权重。模型直接学习本次候选中的相对次序,训练单位与推荐时的列表保持一致。
每份训练列表中,高评分候选均分正例权重。设用户 的候选集合为 ,高评分候选集合为 ,模型原始得分为 :
该用户的损失为:
每个高评分候选获得 的目标权重。只有一部高评分候选时,损失就是这部电影的负对数概率;多部高评分候选共同提供训练目标。
对一条候选的原始得分求导,可得到:
当高评分候选的预测权重小于目标权重时,梯度会推动它的得分提高。其余候选也进入分母,为列表内的相对次序提供训练信号。softmax 在每位用户自己的候选集合中计算,用户之间使用独立的分母。
一份列表的目标权重总和为 1,候选更多时会增加竞争对象。程序对每份查询的损失求平均,使每位训练用户获得一份查询权重。列表中增加相同常数不会改变 softmax;因此这份概率表达候选内的相对分配,无法直接解释成用户实际点击某部电影的概率。
程序对查询求平均,并加入 L2 正则化。设当前查询批次为 ,参与正则化的参数集合为 ,训练目标为:
包含类别 Embedding、Cross 的权重与加性参数,以及 DNN 的权重矩阵。当前 ,优化器使用 Adam,学习率为 0.001。
L2 正则项对参数贡献 的梯度,使训练同时考虑参数大小。Dropout、L2 和验证集选择分别作用于随机停用单元、参数约束和训练轮次。判断过拟合需要观察训练与验证的变化;训练损失继续降低时,验证排名指标仍可能停止改善。
训练批次以查询为单位,默认每批包含 32 份列表。不同列表的候选数量由 RaggedTensor 处理,补齐位置使用较小的数值,使其在 softmax 中的贡献可忽略。
每轮训练后,在固定验证候选上计算 NDCG@20 和 Recall@20。模型选择优先比较 NDCG,再比较 Recall;连续 3 轮没有改善就结束训练,恢复选中轮次的参数。
现有完整模型执行了 4 轮,选择第 1 轮。选中模型在验证集的 Recall@20 为 22.81%,NDCG@20 为 0.09409。验证结果参与模型选择,后面的测试结果来自固定模型。
保存模型后,程序重新加载并比较真实样本的输出。该模型记录的最大绝对误差为 0,确认序列化前后的输出一致。
对应代码:train_ranking.py。
重排与分阶段评估
类型和年代的连续数量限制
重排按排序列表逐项选择。每次取仍未使用、且满足展示限制的最高排名电影,直到前 20 个位置完成。默认连续相同主要类型最多 2 部,连续相同发行年代也最多 2 部。
主要类型取 genres 的第一个值。年代根据发行年份计算,例如 1995 年对应 1990 年代。缺失年份继续使用独立标记。
重排调整候选顺序,保留原有模型分数,并将剩余候选接在展示列表之后。完整 100 个候选保持相同,因此 Recall@100 应当保持一致;前 20 部电影的命中和次序可以变化。
若剩余候选无法继续满足限制,函数立即报告错误。该行为让候选不足或展示规则冲突在发生位置被发现。
对应代码:diversity_rerank.py。
命中、排名与多样性
评估函数保留 merged、ranked 和 reranked 三份列表,分别计算指标。高评分保留目标进入 Top-K 评估,每位用户最多有一个相关目标。
设目标在列表中的位置为 。集合 包含目标进入前 位的用户,未命中用户贡献 0,则:
排名从 1 开始,平均值的分母包含全部评估用户。每位用户只有一个相关目标,Recall@K 与 Hit Rate@K(命中率)在这里相同。目标超出召回目录时仍然计入分母,报告单独记录 unavailable_targets。
Recall 衡量保留目标是否被找到,NDCG 和 MRR 还关注它出现的位置。当前只有一个相关目标,理想列表将它放在第 1 位,IDCG(理想排序的折损累计增益)等于 1。第 1 位对 NDCG 的贡献为 1,第 20 位约为 0.2277;对 MRR 的贡献分别为 1 和 0.05。
Precision@K(前 K 个位置中的相关目标比例)使用推荐位置作为分母。在当前每位用户一个目标、且提供 K 个位置的设置中,它等于 Recall@K 除以 K。这里的相关性只由保留目标判断,其他推荐电影是否符合真实兴趣,数据尚未提供完整标签。
多样性评估记录电影目录覆盖率、类型覆盖率、新颖度、列表内部多样性和最大连续数量。列表内部多样性取电影向量两两之间的平均余弦距离;新颖度使用加 1 平滑后的热门分布计算平均负对数。
Top-K 命中指标使用高评分目标用户,多样性统计使用全部推荐用户。阅读覆盖率时,要连同统计人群一起核对。
来源统计记录各路提议数量、重复候选比例、合并后贡献和独有目标命中。独有目标命中表示只有该路提议了目标电影,这个统计发生在合并预算限制之前。
对应代码:evaluation_metrics.py和 evaluate_pipeline.py。
从测试结果观察排序与重排的作用
评估设置与统计范围
本次使用本地保存的 dcnv2-context-full-20261006 完整模型,在当前代码上重新执行测试集评估。模型读取经过文件、词表、特征参数与代码摘要检查。测试历史只包含 train,include_validation_history=false。
完整模型的召回训练使用 562,194 条样本,导出 3,529 部电影。每路最多生成 100 个候选,合并后最多保留 100 个,最终展示 20 部。
本次为 6,040 位用户生成 120,800 条推荐。高评分测试目标用户有 3,563 位,Top-K 命中指标使用这 3,563 位用户;其中 2 位的目标电影超出召回目录,仍计入分母。
用户分组包含 6,033 位 warm、4 位 short_history、2 位 no_history 和 1 位 unseen_user。高评分目标中,3,562 位属于 warm,1 位属于 short_history。当前汇总结果主要反映历史充分的用户;冷启动效果需要独立的人群评估。
排序带来多少收益
三个阶段使用同一批 3,563 位用户。每位用户的测试目标、推荐时间和历史保持相同,每位用户的 100 部候选电影也保持相同。各阶段只改变候选次序,统一取前 20 部电影评估。
这些用户在每个阶段都贡献 20 部推荐,共 71,260 条。每位用户保留一部高评分目标;这部电影进入前 20 位,就记作一位命中用户。
| 取前 20 部电影的阶段 | 评估用户数 | 命中用户数 | Recall@20 |
|---|---|---|---|
| 合并顺序 | 3,563 | 568 | 15.94% |
| DCNv2 排序 | 3,563 | 717 | 20.12% |
| 类型与年代重排 | 3,563 | 704 | 19.76% |
在同样的 3,563 位用户中,排序使命中人数从 568 位增加到 717 位,增加 149 位。Recall@20 提高 4.18 个百分点,相对提高约 26.2%。
这份比较验证了“候选不变时,训练好的排序流程提高前 20 位命中”。这条流程同时包含类别向量、22 个上下文特征、Cross 与 DNN、listwise 损失及验证集模型选择。将增益进一步归因于某个特征或网络分支,需要固定其他条件进行对应的消融实验,现有结果支持整个排序流程的收益。
目标在前 20 位中的位置也会影响体验。相同用户与相同 20 个位置的排名指标如下。
| 阶段 | NDCG@20 | MRR@20 |
|---|---|---|
| 合并顺序 | 0.06385 | 0.03803 |
| DCNv2 排序 | 0.08225 | 0.04949 |
| 类型与年代重排 | 0.08062 | 0.04846 |
排序后的 NDCG 和 MRR 同时提高,说明目标电影的命中与排名整体改善。
三个阶段的 Recall@100 均为 41.73%,对应 1,487 位命中用户。目标进入完整候选集合后,排序与重排改变它的展示位置;目标未进入候选集合时,这两个阶段无法产生该电影。
Recall@100 单独用于观察 100 个候选的覆盖能力。它与 Recall@20 使用不同列表长度,判断排序收益时使用上面的三份 Recall@20 结果。
重排的效果与取舍
重排后,前 20 位减少 13 位命中用户,Recall 下降约 0.36 个百分点。它同时限制了连续类型与年代,并改变了列表内部的相似程度。
| 阶段 | 电影目录覆盖率 | 列表内部多样性 | 最大连续同类型 | 最大连续同年代 |
|---|---|---|---|---|
| 合并顺序 | 55.31% | 0.19718 | 16 | 20 |
| DCNv2 排序 | 45.71% | 0.15557 | 20 | 20 |
| 类型与年代重排 | 44.52% | 0.16403 | 2 | 2 |
这张表使用全部 6,040 位推荐用户。重排后列表内部多样性高于排序结果,连续数量达成限制,目录覆盖率则有所降低。展示规则与多个评估指标共同决定取舍。
本次结果支持“排序提高前 20 位的命中与排名,重排达成连续数量限制”。它是一套固定模型在一次测试集上的结果,尚未包含多次独立训练的统计区间,也没有线上点击与用户满意度数据。
多路召回的补充作用
四路通道使用相同候选目录,在相同测试用户上评估。
| 通道 | Recall@20 | Recall@100 | 独有目标命中 |
|---|---|---|---|
| YouTube DNN | 15.58% | 40.70% | 258 |
| 物品相似 | 13.58% | 32.92% | 193 |
| 类型兴趣 | 12.80% | 35.39% | 160 |
| 热门 | 9.26% | 27.98% | 143 |
单路预算是 100,合并预算仍然是 100。合并候选的 Recall@100 为 41.73%,高于本次单路结果。独有目标命中说明各路提供了补充候选;每路的最终贡献还受到通道重叠、访问顺序和合并预算影响。
四路共提议 2,370,182 条用户电影记录,重复比例为 33.43%。去重并限制预算后,保留 604,000 条候选。来源信息继续进入排序特征与最终统计。
独有命中统计发生在预算限制之前。研究移除某路的效果,需要在相同预算下重新生成候选并评估,才能得到对应的贡献结果。
AUC、GAUC 和 LogLoss 的解释
AUC(按分数区分正负样本的能力)使用明确的高评分与低评分保留记录。本次包含 3,563 条高评分和 1,064 条低评分,共 4,627 条,AUC 为 0.74350。3 分评分没有进入这项统计。
设正例数为 、负例数为 ,对应得分为 和 。AUC 可由全部正负样本对计算:
随机各取一条正例和负例,正例得分更高就贡献 1,相同得分贡献 0.5。严格递增的得分变换保持 AUC 相同。整体 AUC 可以包含不同用户之间的样本对;推荐列表却只在同一用户内部排序,因此整体 AUC 与前 20 位的效果需要分别评估。
GAUC(按用户分组后汇总的 AUC)需要每位用户具有两类标签。本次每位用户只保留一条测试评分,因此没有符合条件的用户,报告中为 null。
项目按各组样本数量加权。设同时具有正负标签的用户集合为 ,用户 有 条记录,则:
每个用户自己的 AUC 只比较其组内样本。这里明确使用样本数量作为权重,阅读其他项目的 GAUC 时还需要核对其分组与加权规则。
LogLoss(概率预测的对数损失)需要概率输入。当前 listwise 模型输出未校准的排序得分,因此报告中为 null。AUC 可以使用原始得分计算,项目的主要排序评价继续使用 Recall、NDCG 和 MRR。
LogLoss 使用前文 pointwise 交叉熵的平均值,预测值的大小会直接影响结果。对排序得分应用 sigmoid 能得到 0~1 的数值,概率是否可靠还取决于标签定义、训练损失和数据分布。负例采样比例也会改变训练中的正例比例,概率评估应当保留这些条件。当前列表 softmax 的权重随着候选集合变化,真实点击概率需要曝光标签和独立的概率验证。
项目代码的组织
模块职责与源码阅读位置
src/ 中的 34 个 Python 文件按职责组织。阅读时可以从总入口跟随一条请求,再进入具体的数据、特征和模型函数。
| 目录 | 文件 | 职责 |
|---|---|---|
data |
prepare.py、load.py、split.py |
评分核对、输入校验和用户时间划分 |
features |
encode.py、feature_join.py、user_history.py、user_context.py、retrieval_context.py、ranking_features.py |
类别、属性连接、历史、召回评估上下文和排序数值特征 |
models |
youtubednn.py、dcnv2.py、deepfm.py |
召回与排序网络结构 |
training |
retrieval_samples.py、retrieval_inputs.py、train_retrieval.py、ranking_candidates.py、ranking_inputs.py、train_ranking.py、ranking_samples.py、negative_sampling.py |
训练样本、输入转换、候选窗口训练及二分类基线工具 |
retrieval |
vector_recall.py、item_similarity_recall.py、genre_recall.py、popular_recall.py、cold_start.py、merge_recall.py |
四路召回、用户分组和候选合并 |
ranking |
ranking_predict.py |
加载排序产物、生成分数和排名 |
reranking |
diversity_rerank.py |
类型与年代的展示限制 |
evaluation |
evaluate_retrieval.py、evaluation_metrics.py、evaluate_pipeline.py |
召回指标、综合指标和完整流程评估 |
pipeline |
prepare_data.py、artifact_store.py、run_pipeline.py |
数据准备入口、模型目录管理和命令行流程 |
config/offline.yaml 保存阈值、模型维度、训练参数和候选数量。scripts/ 提供数据下载、编码检查及真实用户示例请求生成。tests/ 验证数据规则、历史边界、真实模型训练、保存加载、召回、排序、重排和评估。本次代码版本的 75 项测试全部通过。
模型目录与结果记录
训练结果以完整模型目录保存。retrieval/ 包含用户模型、电影模型、编码器、电影编号和向量;ranking/ 包含排序模型、编码器、数值标准化参数与训练记录;indexes/ 包含用户、电影、历史及三种索引。
manifest.json 记录模型文件、来源数据和全部功能源码的 SHA-256,以及训练用户、训练记录和目录规模。加载时检查文件集合、摘要、词表次序、输入形状和训练配置。电影编号数组与向量行序也必须一致。
这些校验用于追踪版本与发现文件不一致。重新训练应当使用新的输出目录,推荐与评估也需要新的空结果目录。
推荐结果分别保存在 recall-*.csv.gz、merged.csv.gz、ranked.csv.gz、reranked.csv.gz 和 final.csv.gz。评估额外保存 evaluation_report.json,可以查看候选阶段、用户分组和来源贡献。
train-ranking 可以复用已有召回模型及索引,单独训练排序模型。复用来源和摘要会写入新的模型记录,便于比较排序设置。
对应代码:artifact_store.py。
参考文献与资料
- Covington, P.、Adams, J. 和 Sargin, E.(2016)。Deep Neural Networks for YouTube Recommendations。RecSys 2016。候选生成模型的论文来源。
- Wang, R. 等(2021)。DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems。WWW 2021。特征交叉网络的模型论文。
- TensorFlow。tf.nn.sampled_softmax_loss。采样训练损失的接口与参数说明。
- TensorFlow Recommenders。Cross 0.7.3 源码。本文完整矩阵交叉层的实际计算规则。
- GroupLens。MovieLens-1M 官方说明。评分、用户属性、电影属性和时间字段的数据说明。
- Datawhale。FunRec。本项目模型学习、数据处理和电影属性整理的参考项目。
- Guo, H. 等(2017)。DeepFM: A Factorization-Machine based Neural Network for CTR Prediction。IJCAI 2017。共享向量与 FM 二阶交互的论文来源。
- Rendle, S. 等(2009)。BPR: Bayesian Personalized Ranking from Implicit Feedback。UAI 2009。按用户的候选对学习相对次序。
- 牛客。虾皮推荐算法一面面经和 网易推荐算法面经:日常实习。用于确定模型、采样、损失和收益解释的讲解深度,技术推导以论文及项目源码为依据。
评论由 GitHub Giscus 提供。若当前网络无法加载,可 前往 GitHub Discussions 查看或参与讨论。