WHALE-RecFlow 复现:从曝光日志到逐层融合排序模型
同一个用户最近看过体育、音乐和美食视频。面对一个新的篮球候选,排序模型需要同时理解两类信息:候选的作者、类别与用户属性之间的关系,以及历史中哪些行为能够说明当前兴趣。
WHALE 把特征交互和历史建模放进同一个逐层计算过程。这个项目使用 PyTorch,在 RecFlow 真实曝光数据上实现五个模型,研究历史信息应当怎样进入特征交互。完成的实验使用 3,000,000 条训练目标和 200,000 条测试目标,WHALE 的测试 AUC 为 0.757566,LogLoss 为 0.459887。
1 排序任务与研究问题
推荐系统通常经过召回、预排序、排序和重排序等环节。召回从大量物品中寻找候选,排序结合更多特征估计用户对候选的反馈。这个项目关注曝光空间中的单条样本预估:给定用户、候选视频、上下文和允许使用的历史,预测业务长观看反馈的概率。
这里,u 表示用户,v 表示当前候选,c 表示请求上下文,t 表示目标请求时间。标签 y 使用 RecFlow 发布的 long_view。历史集合只包含当前离线规则允许使用的记录。
项目研究两个相互关联的问题。其一,用户、候选和上下文的组合如何影响预测。其二,模型能否根据这些组合,从历史中多次读取相关信息。[1]
例如,“体育类别”与“此前看过篮球视频”分别有用。两者结合后,候选相关的历史读取可能提供更直接的证据。WHALE 用 Wukong 处理特征交互,用 HSTU 处理历史关系,并在每层通过 Attention Fusion(注意力融合)连接两部分。
固定的五个模型分别提供不同观察角度:
| 模型 | 计算路径 | 关注的问题 |
|---|---|---|
| Wukong | 非序列特征 → 特征交互 → 预测 | 只使用用户、候选和上下文的效果 |
| HSTU | 历史物品与反馈交替输入,末尾放入候选 | 候选直接参与序列计算的效果 |
| Shallow-hybrid | 历史摘要 → Wukong → 预测 | 一次摘要融合的效果 |
| WHALE | 每层执行特征交互、历史建模和 Attention Fusion | 逐层读取历史的效果 |
| WHALE MeanPool | 保持逐层结构,使用历史均值进行读取 | 候选相关读取的效果 |
本项目属于公开数据上的结构复现。Embedding 维度为 64,层数为 2,历史上限为 128。原论文还研究了工业数据、长序列和模型规模扩展,这些结论需要相应的实验条件。[1]
2 读懂 RecFlow 的曝光数据
2.1 曝光、请求与候选
RecFlow 记录了工业推荐流程中的多个阶段。项目使用其中的 realshow 文件,日期为 2024-01-13 至 2024-02-18,共 37 个日文件。完整读取后的统计如下:
| 统计对象 | 数量 |
|---|---|
| 实际曝光记录 | 38,245,315 条 |
| 具有实际曝光的请求 | 7,440,759 个 |
| 用户 | 39,011 个 |
| 曝光视频 | 8,773,147 个 |
一条曝光记录对应某个用户在某次请求中看到的一个视频。同一请求可以包含多个视频,因此曝光数量大于请求数量。request_id 用于组织请求,video_id 标识视频,二者不能互相替代。
RecFlow 论文表 1 的全流程请求数为 9,370,581。这个数字覆盖更广的阶段数据,与本项目实际曝光请求的统计范围不同。[2]
当前候选表示“这一条样本需要预测的视频”。训练、验证和测试都有候选。候选的作者、类别和时长属于预测输入,候选的最终反馈用于监督或指标计算。
2.2 正负样本与业务目标
正例直接使用 long_view=1,负例直接使用 long_view=0。它们都来自实际曝光记录。目标抽样在对应时间区间内进行,没有额外按标签调整比例,也没有人为抽取未曝光视频作为负例。
这使任务能够表达“看到以后是否产生长观看”。未曝光视频缺少相同意义的观看反馈。RecFlow 中未曝光记录的反馈字段被填为 0,直接混入会改变监督含义。[2]
effective_view 和 long_view 都是业务定义的二值反馈。论文说明 long_view 的条件更严格,没有公开一个可以直接还原标签的统一完播公式。[2]
项目保留发布的业务标签。完整正时长记录中,有 2,576,614 条同时满足 playing_time < duration 和 long_view=1。这说明最终观看时长与视频时长的比较无法替代 long_view。同样,长观看标签也不能直接解释为严格完播。
2.3 字段的使用边界
| 字段类别 | 使用的字段 | 用途 |
|---|---|---|
| 用户与上下文 | user_id、device_id、age、gender、province | 当前候选的非序列输入 |
| 候选视频属性 | video_id、author_id、category_level_one、category_level_two、upload_type | 当前输入,并与历史共享 Embedding |
| 时间与数值 | duration、request_timestamp、upload_timestamp | 构造时长、时间周期和视频年龄 |
| 历史反馈 | effective_view、long_view | 描述满足历史条件的过去事件 |
| 当前候选反馈 | long_view | 监督目标 |
| 组织与核验 | request_id、来源文件、来源行号、event_id | 构造历史、保存成员关系和核对预测 |
playing_time 用于估计历史反馈可用时间。当前候选的观看时长和最终反馈不会进入候选表示。原始排序位置、推荐阶段标记,以及点赞、关注等其他反馈也没有加入本轮模型输入。
这种字段边界保证训练目标有清楚的含义。模型需要依据预测时的属性与历史估计结果。把当前观看结束后才能取得的信息加入候选,会改变问题本身。
2.4 为什么选择 RecFlow
RecFlow 同时具有用户属性、视频属性、业务反馈、请求编号与连续日期记录。这些字段能够分别支持 Wukong 的特征交互、HSTU 的历史建模和 Fusion 的候选相关读取。实际曝光中的正负反馈,也使排序目标能够直接建立在发布标签上。
历史来源保留了较多用户行为,当前 128 条主要由实验计算预算限定。数据选择需要同时考虑字段含义、历史覆盖和可核对程度。项目通过全量字段读取与历史成员统计确认这些条件,再确定正式数据方案。
3 从原始曝光到固定目标成员
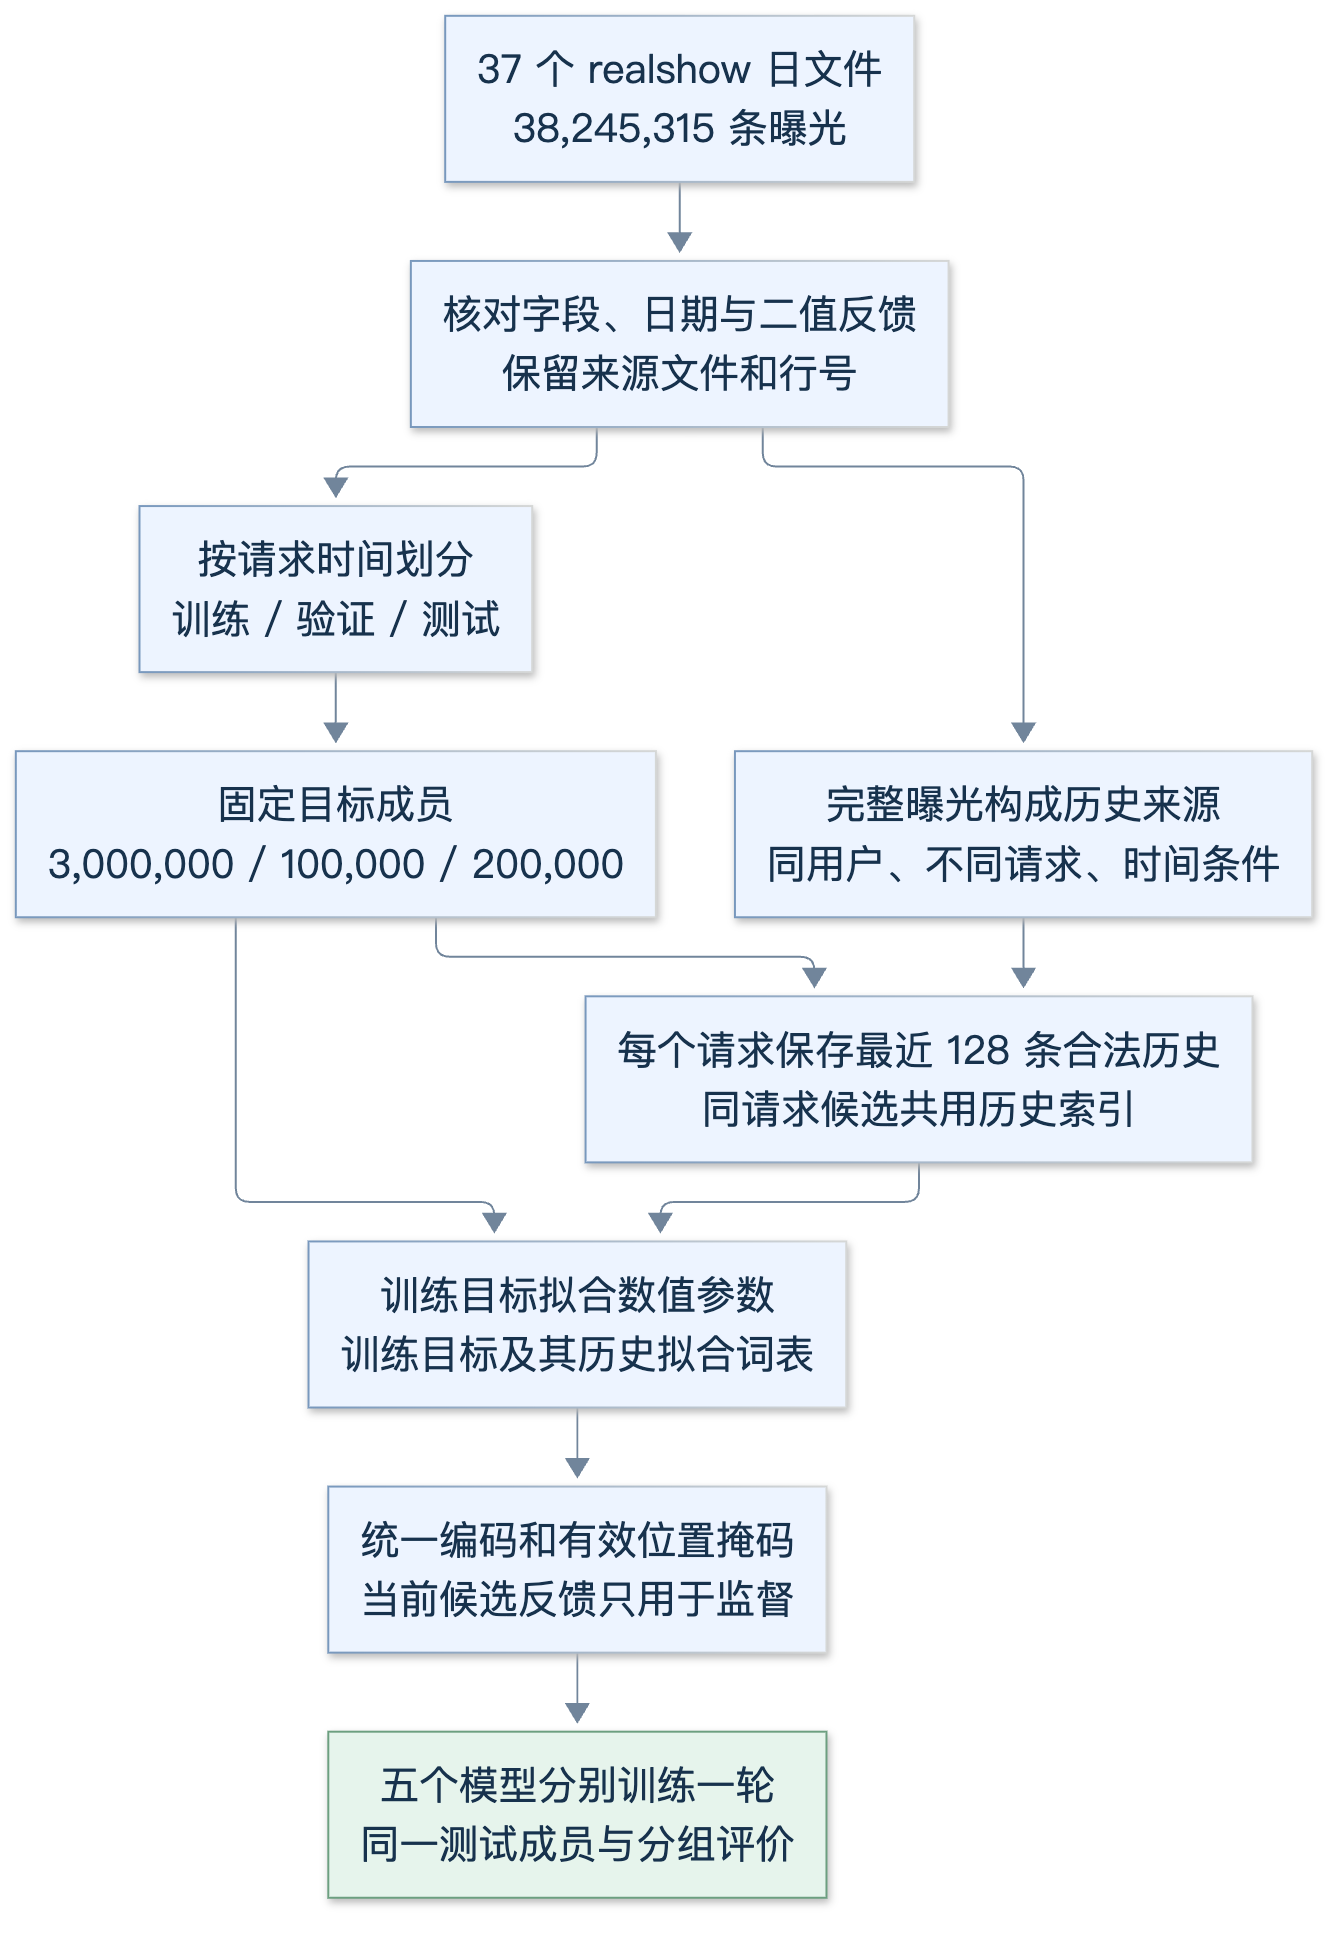
图 1 根据项目的数据加工流程绘制。历史来源与监督目标分别管理。
3.1 原始文件核验与事件编号
加工程序检查文件数量、请求日期、必要字段和整数类型。还会检查二值反馈的取值、观看时长非负,以及同一请求的用户和请求时间是否一致。必要字段缺失或类型异常时,程序立即终止。
每条曝光保留来源文件编号和来源行号。全局事件编号由两者确定:
其中,文件编号从 0 开始,行号从 1 开始。这个编号用于确定记录身份,不作为模型输入。它让样本关系能够通过实际成员逐条核对,也让后续预测能够连接回原始曝光。
3.2 时间划分与抽样
划分使用 Asia/Shanghai 时区,请求时间区间为左闭右开。
| 集合 | 请求时间区间 | 目标数量 | 正例数量 |
|---|---|---|---|
| 训练 | 2024-01-13 00:00 ~ 2024-02-08 00:00 | 3,000,000 | 715,000 |
| 验证 | 2024-02-08 00:00 ~ 2024-02-12 00:00 | 100,000 | 21,940 |
| 测试 | 2024-02-12 00:00 ~ 2024-02-19 00:00 | 200,000 | 45,319 |
时间划分让模型使用过去训练,并在后续日期评价。随机划分全部曝光,容易让同一时期的用户和视频分布同时进入训练与测试,难以表达后续日期的新内容问题。
早期实验使用 1,000,000 条训练目标。正式实验完整保留这些成员,从训练区间剩余曝光中均匀无放回抽取 2,000,000 条。验证和测试成员完整复用,随机种子为 42。
抽样对象是曝光记录。同一请求的多个曝光可能同时入选,因此样本数量与唯一请求数量不同。五模型使用同一份目标索引,模型比较能够对应到同一批事件。
3.3 为什么保留完整曝光作为历史
3,000,000 条表示参与损失计算的训练目标数量。历史来源保留全部 38,245,315 条曝光,并按照每个目标的用户与时间筛选。没有入选监督目标的曝光,仍然可能成为后续样本的历史。
这与日常使用推荐系统的情况一致:用户此前看过哪些视频,不取决于这些观看是否恰好入选离线训练目标。只从抽样目标中生成历史,会同时减少监督和历史覆盖,改变序列模型能够获得的信息。
同一请求下的候选共享用户与请求时间,因此可以保存一份历史索引,再通过目标到请求的映射进行读取。正式数据共涉及 2,567,033 个唯一目标请求,减少了重复历史存储。
4 构造目标时刻允许使用的历史
4.1 请求发生时间与反馈可用时间
历史中存在一个时间问题:一条视频在此前被请求,并不意味着最终观看反馈已经回传。RecFlow 提供请求时间和最终观看时长,公开字段没有直接给出每项反馈的真实完成时间。[2]
当前协议以请求为单位估计反馈可用时间。对于请求 r:
式中,t_r 为请求时间,求和范围是该请求的全部实际曝光。项目把 playing_time 按毫秒解释,额外等待 60,000 毫秒。请求内所有曝光共享这一个估计时间。
这里包含明确的项目假设:累计观看时长近似描述请求消费进度,额外 60 秒提供等待间隔。真实播放、重复观看与反馈回传的时间关系没有完整记录,因此公式只能定义当前离线输入规则。
60 秒没有经过线上延迟测量。保持其他规则时,额外等待从 0 秒变为 60 秒,会使 19.4165% 的正式测试目标使用不同的历史成员。这个比例来自数据成员诊断,尚未测量它对应的 AUC 变化。解释实验结果时,需要保留这项条件。
4.2 合法事件的四个条件
目标请求为 (u,t,r) 时,历史事件 e 需要满足:
四个条件分别限定同一用户、不同请求、请求时间严格更早,以及估计可用时间严格更早。
同请求排除很重要。同一请求中的多个候选共享推荐发生的时刻,如果把它们最终的反馈相互用作历史,就会把当前请求的结果带入预测。对于不同请求但时间相同的记录,当前协议也统一排除。
程序按 (request_timestamp, request_id, event_id) 排序,取最近的 128 条合法事件,再按时间升序输入模型。若最近的一段记录不足 128 条,继续向更早的位置搜索。这样,筛选近期不可用事件后,还能够补充更早的合法事件。
历史不足时在右侧填充 PAD(填充位置)。正式目标的历史统计为:
| 集合 | 平均有效长度 | 达到 128 条的目标 | 空历史目标 |
|---|---|---|---|
| 训练 | 120.3052 | 2,681,354 | 16,922 |
| 验证 | 125.2876 | 95,967 | 152 |
| 测试 | 125.8001 | 193,493 | 217 |
4.3 滚动历史与固定模型参数
验证和测试使用滚动历史。后面的目标可以读取更早、且满足可用条件的评价期事件。模型参数在评价期间保持固定,词表与数值参数也保持固定。
“读取新增历史”和“使用测试标签更新模型”是两个不同操作。前者更新每条样本的上下文,后者会改变模型参数。本项目只进行前者,并继续受上述历史时间假设约束。
4.4 作者提供的 50 条历史如何理解
RecFlow 还提供最近 50 条有效观看历史,原论文实验采用这类历史输入。[2] 项目对作者数组完成了真实数据核验:正式目标请求的键覆盖率为 100%,核对的 120,224,314 次历史出现均能够连接回曝光表。
这项核验确认条目来源,也帮助核对时间单位。它没有提供真实反馈回传时刻。作者数组只包含有效观看,与当前保留不同反馈的曝光历史,在行为选择和长度上都有差异。
因此,使用作者历史需要作为另一套明确的数据协议报告。当前正式结果继续采用曝光历史,能够在固定输入规则下比较五个模型。
5 字段编码与输入表示
5.1 类别词表与 UNK
Embedding(嵌入)把离散编号映射到可学习向量。对于字段 f,编码后的编号 i 对应表中的一行:
年龄分组、性别、地区与各级类别也使用独立词表。匿名编号的数值大小通常没有可直接使用的连续距离含义,Embedding 让表示通过任务训练获得。
词表只拟合训练输入。用户与上下文字段使用训练目标;历史视频相关字段使用训练目标及其合法历史的并集。验证和测试只应用已经确定的字典。
编号约定为 PAD=0、UNK=1,其余已知类别从 2 开始。UNK 表示未知类别,多个未见编号共享对应字段的同一行向量。PAD 表示位置不存在,模型通过有效位置掩码排除它。原始反馈 0 和 1 编码为 2 和 3,因此负反馈也有有效表示。
候选与历史视频共享视频、作者、类别和上传类型的 Embedding 表。历史中出现的条目也能参与这些表的学习。词表中的“已见”表示进入了训练拟合范围,不等于作为训练目标频繁出现。
正式视频表共有 6,513,912 行,其中包含 PAD 与 UNK 两个保留位置。表中进入训练拟合范围的视频数量为 6,513,910。这个数量大于训练目标数,原因是词表还包含训练目标允许使用的历史视频。
5.2 数值特征的转换
数值输入分为三个组,共 8 个数值:
| 数值组 | 特征 | 处理目的 |
|---|---|---|
| 视频时长 | log1p(duration / 1,000)、时长缺失标记 | 表达时长差异与缺失情况 |
| 请求时间 | 小时 sin/cos、星期 sin/cos | 表达时间周期 |
| 视频年龄 | log1p(距上传的天数)、年龄缺失标记 | 表达内容新近程度与缺失情况 |
时长小于等于 0 时记为缺失。上传时间无效,或晚于目标请求时间时,视频年龄记为缺失。两个经过 log1p 转换的特征,用训练目标的有效观测均值填充,再用训练目标统计进行标准化:
有效标准差为 0 时,只进行中心化。缺失标记保持原值。这样,模型既能处理缺少的数值,也能识别“这个数值原本缺失”。
周期编码把一天中的小时 h 表示为:
星期使用相同方式,将分母改为 7。这样,午夜前后的时间在表示上仍然接近。周期值直接保留,项目只标准化对数时长和对数视频年龄。
每个数值组经过 输入维度 → 64 → 64 的 MLP(多层感知机),形成一个 Token(表示单元)。与 10 个类别 Token 合并后,非序列输入为 13 × 64。
5.3 历史事件怎样形成一个 Token
WHALE、Shallow-hybrid 和 MeanPool 使用相同的联合事件编码。每条历史包含 5 个视频属性 Embedding、2 个反馈 Embedding,以及一个相对请求年龄:
因此,拼接维度为 5 × 64 + 2 × 64 + 1 = 449。经过 449 → 128 → 64 的 MLP,每个事件形成一个 64 维 Token。历史张量的形状为 B × 128 × 64,B 表示批量大小。
PAD 不参与有效历史的读取。HSTU 的各层输出会再次乘以有效位置掩码,防止线性层的 bias 或残差计算使填充位置重新产生有效数值。
5.4 为什么训练中遮盖部分 ID
测试目标中,133,106 条视频 ID 没有进入训练词表,占 66.5530%。新视频在后续日期出现,是时序评价需要面对的情况。它们共享视频 UNK 向量,但作者、类别、时长等其他属性仍然可能提供信息。
训练时,项目以 0.05 的概率,将已知的用户、设备、视频和作者编码替换为 UNK。有效历史中的视频与作者也进行相同处理。标签、历史反馈、时间和 PAD 保持原值,评价使用自然编码。
这相当于对指定 ID 输入进行随机遮盖。它让 UNK 向量获得训练机会,也让预测学习利用其他属性。评价时自然出现的 UNK 则反映真正未进入训练词表的编号,两者的来源应当分别理解。
6 Wukong:让特征之间发生交互
6.1 从 FM 理解特征组合
单独看到“体育类别”或“晚间请求”,模型能够学习各自与目标的关系。特征交互进一步表达二者组合时的效果。Factorization Machine(因子分解机,FM)用向量内积表示二阶交互:[3]
二阶项能够改写为:
展开平方后,去掉每个特征与自身的乘积,剩余的每对交互出现两次。因此乘以二分之一,计算可以从逐对求和转为逐维累加。
Wukong 进一步把交互结果映射回 Token 表示,并重复进行交互。当前项目使用完整内积矩阵,它与标量 FM 的计算结果具有不同形状。[3]
6.2 FMB 与 LCB
设输入为 X ∈ R^(n×D)。Factorization Machine Block(因子分解机模块,FMB)计算:
G 的每个元素表示一对 Token 的内积。项目保留完整 n × n 矩阵,再执行:
第一层输入为 13 个 Token,因此 Gram 矩阵包含 169 个数值。MLP 的维度为 169 → 128 → 256,输出恢复成 4 个 64 维 Token。后续层输入为 8 个 Token,Gram 矩阵包含 64 个数值。
Linear Compression Block(线性压缩模块,LCB)在 Token 维度进行可学习组合:
FMB 生成 4 个交互 Token,LCB 生成 4 个线性组合 Token。二者拼接后,加上残差分支并归一化:
第一层把 13 个 Token 转成 8 个 Token,残差需要进行 Token 维度投影。后续 8 → 8 的层直接使用原输入作为残差。这里的 LayerNorm(层归一化,LN)沿每个 Token 的特征维度计算。
6.3 多层交互的作用
后续层对已经组合过的表示再次计算内积,能够表达更高阶的关系。这里的高阶表示表达能力随层次变化,并不意味着每层输出可以直接解释为唯一一种固定阶数。
Wukong 模型使用两层交互,将最终 8 × 64 表示展开成 512 维向量,经预测头输出 logit(对数几率分数)。它的前向计算只读取非序列输入,作为历史模型的重要参照。
7 HSTU:编码历史关系与反馈
7.1 HSTU 的单层计算
HSTU 的完整名称是 Hierarchical Sequential Transduction Unit(分层序列变换单元)。它使用带门控的序列聚合,并引入相对位置与时间信息。[4]
对单个 Head(注意力头),当前实现先归一化输入,再进行一次联合投影与 SiLU 激活:
SiLU 的表达式为:
项目使用 4 个 Head,每个 Head 的 Q、K 和 V 维度均为 16。聚合分数计算为:
M 是有效位置与时间条件组成的掩码,L_max 为模块配置的最大长度。各行分数通过 SiLU 变换,保留相对强度信息。它们没有经过逐行 Softmax,因此不要求和为 1,也不具备概率权重的解释。[4][5]
随后先对 V 进行加权求和,再归一化聚合结果,并与 U 逐元素相乘:
多个 Head 的结果在输出前拼接。项目中 HSTU 的归一化没有可学习仿射参数,联合输入投影没有 bias,输出投影包含 bias。输出残差保留原表示,也为梯度传播提供直接路径。
7.2 时间分桶与因果掩码
相对位置表示先后关系,时间分桶表示实际间隔。同样相隔两个事件,可能对应几秒,也可能对应几天。
当前时间分桶计算为:
每个桶对应一个可学习的时间 bias,时间 bias 与位置 bias 相加。这里的对数为自然对数,0.301 是实现采用的除数。[5]
WHALE 等共同历史分支中,一个历史位置可以读取严格更早请求时间的历史和自身。不同事件具有相同请求时间时,它们之间的读取会被排除。有效位置掩码还会排除所有 PAD。
这层掩码控制历史内部的信息传播。目标历史的筛选已经在数据加工阶段完成,两者分别约束“输入了哪些事件”和“事件之间怎样读取”。
7.3 HSTU-only 的交替排序输入
HSTU-only 将每条历史分别编码成物品 Token 和反馈 Token,末尾加入当前候选:[4]
物品编码使用 5 × 64 + 1 = 321 维输入;反馈编码使用 2 × 64 = 128 维输入;候选编码使用 13 × 64 = 832 维输入。三者分别经过 MLP,映射为 64 维 Token。
实际有 L 条历史时,候选位于从 0 开始编号的 2L 位置。张量最大长度为 2 × 128 + 1 = 257。有效位置截止到候选,其余位置作为 PAD。
因果顺序允许候选读取历史,历史位置只读取因果条件允许的前文。反馈 Token 可以读取同一事件的物品表示,候选的当前标签不会生成反馈 Token。时间 bias 还采用下一事件时间的计算约定,与共同历史分支分别实现。
最终使用候选位置的表示预测 long_view。因此,这个模型仍然进行排序概率预估。使用 HSTU 模块,并不意味着项目训练了覆盖全部物品空间的生成式召回系统。
8 WHALE:每层让特征表示查询历史
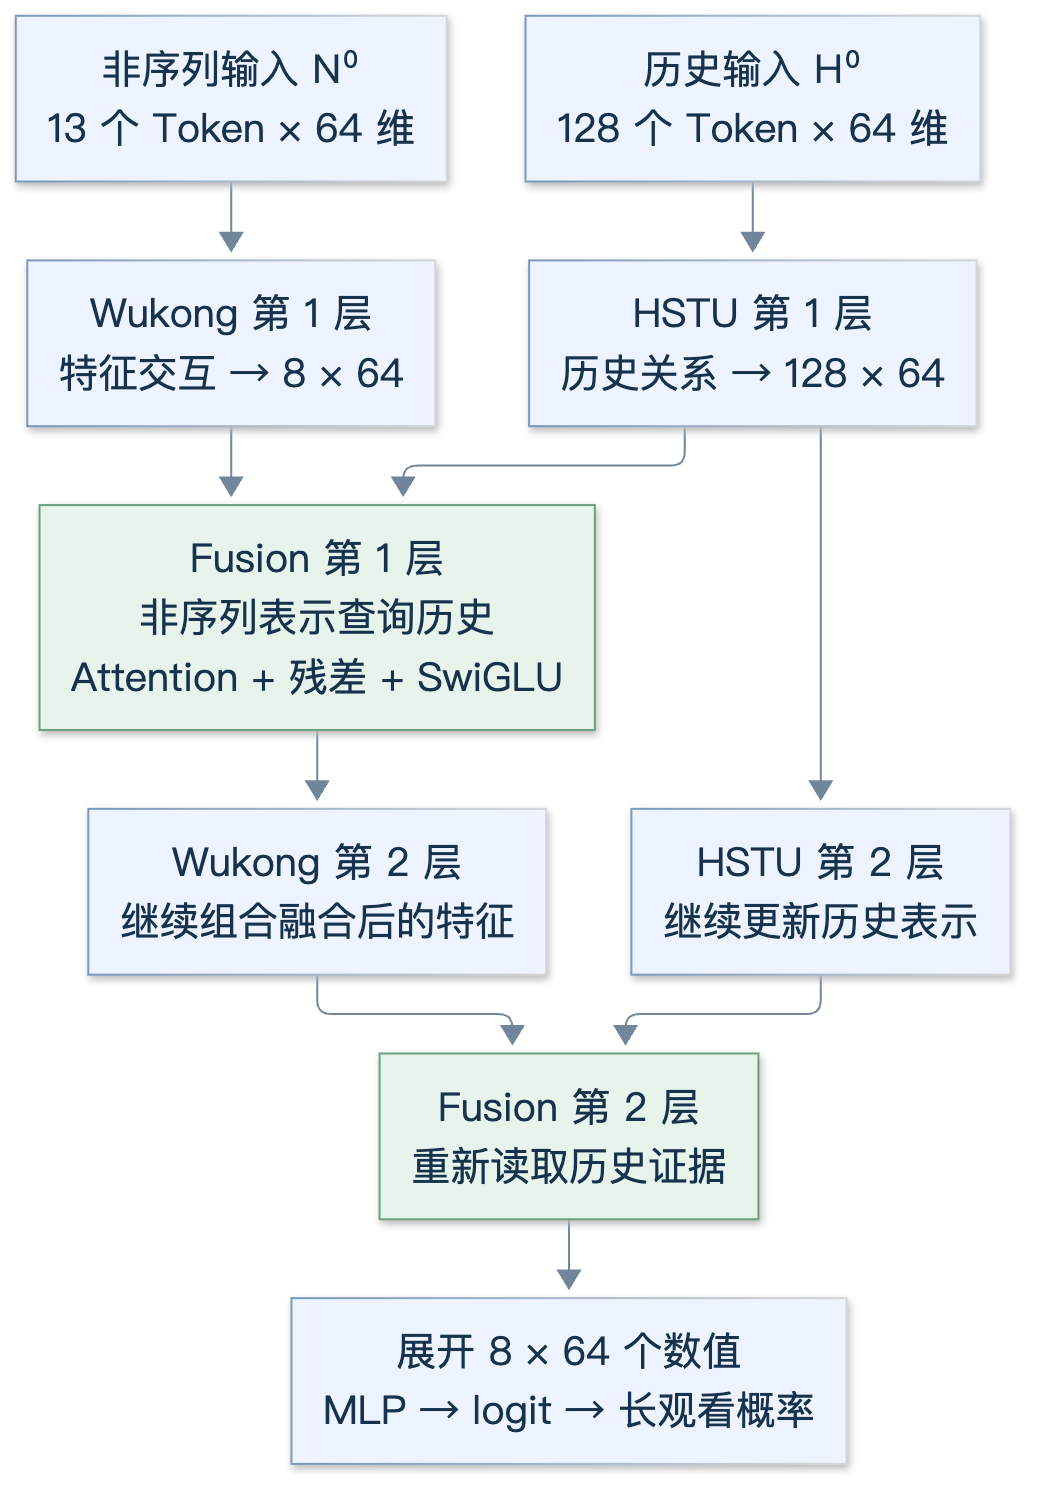
图 2 根据当前源码绘制。Fusion 更新非序列分支,历史分支通过自身的 HSTU 层继续更新。
8.1 两个分支分别更新
设第 ℓ 层输入为非序列表示 N^(ℓ) 和历史表示 H^(ℓ)。WHALE 在这一层分别计算:
Wukong 得到当前层的特征组合。HSTU 得到当前层的历史关系表示。Fusion 随后让特征组合读取历史,并将读取结果传递给下一层 Wukong。
当前结构中的历史分支不接收 Fusion 输出。候选相关性主要通过非序列 Query 和历史读取产生。这个方向使历史表示在结构上具有跨候选复用的条件;本项目的批次训练仍然按目标进行计算,没有实现线上请求级缓存。[1]
8.2 Cross-Attention 怎样选择历史
Fusion 使用 Cross-Attention(交叉注意力)。Query 来自本层非序列表示,Key 和 Value 来自本层历史表示:
读取结果为:
D=64。非序列分支具有 8 个 Query,历史最多有 128 个 Key,因此分数矩阵为 8 × 128。每个 Query 都能对历史使用不同权重。除以根号 D,有助于控制内积数值随维度增长的幅度。
PAD 对应位置在 Softmax 前设为负无穷。有效历史的权重和为 1。空历史单独返回零读取结果,避免在全部位置无效时执行归一化。
Fusion 的 Softmax 与 HSTU 的 SiLU 聚合具有各自的作用。前者在当前历史集合中形成归一化读取,后者编码历史位置之间的关系。阅读实现时,需要根据模块分别理解分数含义。
8.3 残差与 SwiGLU
非序列表示与读取结果在特征维度拼接,经线性投影后加入残差:
随后通过带门控的前馈网络:
这个前馈网络采用 SwiGLU。两路投影分别产生门控分支和数值分支,逐元素相乘后投影回 64 维。隐藏维度为 128,当前每层的 Fusion 使用独立参数。
经过一层融合后,下一层 Wukong 接收的表示已经包含历史信息。下一层 Query 也随之变化,能够依据更新后的特征组合再次读取历史。这正是逐层融合与一次固定摘要的机制区别。
9 两种融合对照怎样解释
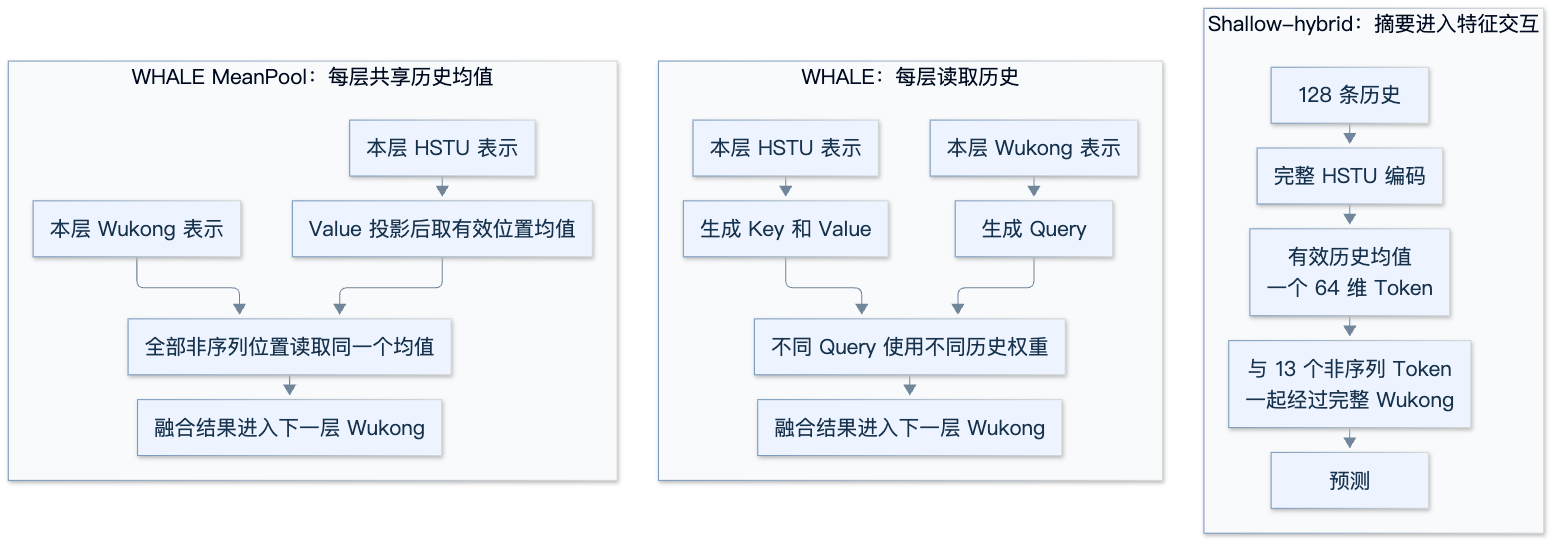
图 3 展示当前项目的具体计算路径。浅层摘要和每层均值读取使用不同的位置与时机。
9.1 Shallow-hybrid
Shallow-hybrid 先完成两层 HSTU 编码,对有效历史取均值:
这个 64 维摘要作为第 14 个 Token,与原有 13 个非序列 Token 一起进入两层 Wukong,再通过预测头输出分数。
历史信息在进入 Wukong 前已经压缩成一个向量。后续特征交互可以使用该摘要,但无法重新访问每个历史位置。这个设计参考论文中的浅层融合思路;使用有效历史均值和一个摘要 Token 属于本项目适配。[1]
9.2 WHALE MeanPool
MeanPool 保留完整 WHALE 的两层组织方式,每层都执行 Wukong、HSTU 和融合。它将投影后的历史 Value 取有效位置均值:
随后,把同一个均值复制给所有非序列位置,继续使用相同的融合投影、残差和 SwiGLU。空历史读取为零。
这个对照保留逐层访问历史的时机,改变历史读取的方式。完整 WHALE 根据 Query 生成权重,MeanPool 对有效历史使用相同权重。比较两者,可以观察候选相关读取在当前配置中的价值。
10 训练规则与工程实现
10.1 单轮训练包含多少更新
正式实验中,每个模型完整遍历 3,000,000 条训练目标,Batch Size 为 256:
前 11,718 批各有 256 条,最后一批有 192 条。一次 Epoch(完整遍历)包含这些参数更新,日志中的 Epoch 0 对应第一轮。
样本顺序采用日期升序、日内打乱。每日的随机顺序、ID 遮盖和模型初始化都由确定的种子规则控制。日期顺序保留数据推进方向,日内打乱减少连续样本排列对批次的固定影响。词表仍按完整训练范围拟合,所以这套流程属于离线训练。
单轮设置参考 WHALE 与 RecFlow 的实验习惯,也结合早期实验现象:四个历史模型在第一轮取得最佳验证表现,继续训练时训练损失下降、验证表现恶化。Wukong 的早期最佳权重来自第二轮,因此单轮是一致的实验规则,不能保证每个模型达到各自最优效果。
10.2 从 Bernoulli 似然到交叉熵
模型输出 logit s,概率为:
二值标签的 Bernoulli 似然为:
取负对数,得到二元交叉熵:
项目使用 BCEWithLogitsLoss,直接对 logit 计算稳定形式:
对 logit 的梯度为 σ(s) − y。这个损失直接对应概率估计,能够惩罚置信度很高的错误预测。训练损失按实际样本数量加权,最后不足整批的样本不会获得额外权重。
当前损失按单条目标计算,属于 Pointwise(逐点)预估。它没有显式构造同一请求的正负对,也没有优化整个候选列表的排序损失。最终概率仍可作为候选排序分数,但本项目的报告范围是离线概率与区分能力。
10.3 优化器、归一化与梯度
优化器使用 AdamW,学习率为 0.001,weight decay 为 0.00001。Adam 的更新根据梯度一阶矩与二阶矩进行调整,AdamW 将权重衰减与自适应梯度更新分别处理。[6]
以梯度 g_t 为例,主要计算为:
经过初始阶段校正后,用一阶矩除以二阶矩平方根,形成各参数的更新量。项目还将全体梯度的范数限制在 1.0,超过阈值时统一缩放,保留梯度方向。
LayerNorm 沿单个 Token 的特征维度计算均值和方差,不依赖当前批次内其他样本。BatchNorm(批归一化)依赖批次统计,训练和推理通常使用不同的统计方式。当前模型使用 LayerNorm,更适合在不同历史长度和批次内容下保持一致的归一化计算。
正式计算采用 FP32(32 位浮点),使用 RTX 5090 32 GB。五个模型顺序训练,全部使用同样的训练目标和最终测试成员。[7]
10.4 保存、恢复与结果核验
源码按照数据处理、模型计算和训练评价组织。data/ 负责原始读取、划分、历史和编码;models/ 负责 Embedding、Wukong、HSTU、Fusion 和预测头;training/ 负责优化、恢复、评价与分组报告。
恢复文件保存模型、优化器、训练进度与随机状态,并核对配置和数据成员关系。恢复边界位于 Epoch 结束处。单轮最终权重用于正式验证和最终测试,评价通过 eval() 和关闭梯度计算保持参数固定。
项目使用真实数据完成前向、反向、参数更新、UNK 梯度、候选位置、时间掩码、PAD 和权重重新加载的必要核验。正式结果还核对了五模型的测试事件、标签和逐条预测,并从保存的预测重新计算整体与分组指标。
这类核验回答不同问题:运行检查确认计算过程能够完成,成员检查确认比较对象一致,指标复算确认报告与预测对应。指标高低仍然需要由真实实验评价。[7]
11 指标、结果与计算成本
11.1 AUC 衡量什么
AUC 可以解释为:随机选取一个正例和一个负例,模型给正例更高分数的概率。相同分数计为半次正确:
实际计算可以通过排序和秩统计完成,无需枚举全部正负配对。全局 AUC 也包含不同用户之间的配对,因此它不能单独描述每个用户内部的排序效果。按用户计算 AUC,再按明确权重汇总,可以得到相应的 GAUC(分组 AUC);本项目正式指标没有计算 GAUC。
AUC 关注分数的相对次序。对分数进行严格单调变换,排序关系可以保持相同,但预测概率会改变。因此,AUC 提升与概率误差改善需要分别观察。[8]
11.2 LogLoss 与 NE
LogLoss 是完整评价集合上的平均交叉熵。它同时考虑标签与预测概率,对置信度很高的错误预测给予更大惩罚。较低 LogLoss 说明该损失下的概率预测更好;概率校准还需要专门的分桶或校准指标支持。
Normalized Entropy(归一化交叉熵,NE)用当前集合的正例比例 p 构造参考熵:
测试正例比例为 45,319 / 200,000 = 0.226595。NE 小于 1,表示模型的 LogLoss 低于始终输出该集合正例比例的固定概率参考。这里的参考用于评价归一化,不作为训练输入。
同一集合的分母相同,因此 NE 与 LogLoss 的模型顺序一致。不同集合的正例比例可能变化,跨集合比较 NE 仍需结合样本定义理解。项目在完整集合上计算指标,分组也按各组完整预测计算,没有平均批次 AUC。
11.3 五个模型的正式结果
| 模型 | 测试 AUC ↑ | 测试 LogLoss ↓ | 测试 NE ↓ |
|---|---|---|---|
| Wukong | 0.727525 | 0.477824 | 0.892913 |
| HSTU | 0.756088 | 0.462144 | 0.863612 |
| Shallow-hybrid | 0.754102 | 0.463354 | 0.865872 |
| WHALE | 0.757566 | 0.459887 | 0.859394 |
| WHALE MeanPool | 0.754784 | 0.462278 | 0.863863 |
相对 HSTU,WHALE 的 AUC 增加 0.001478,即约 0.1478 个百分点。LogLoss 降低 0.002257,NE 相对降低 0.4884%。相对 Shallow-hybrid,AUC 增加 0.003464;相对 MeanPool,增加 0.002783。[7]
这些结果与逐层融合和候选相关历史读取的设计方向一致。Shallow-hybrid 还使用了项目定义的均值摘要,因此差值评价的是这里的完整配置,无法单独量化某一个模块的贡献。
交互组件可以切换 AUC、LogLoss 和 NE,查看不同参照模型下的差值。全部数值来自本轮保存的最终测试结果。
11.4 未见视频上的表现
| 测试分组 | 目标数量 | HSTU AUC | WHALE AUC | HSTU LogLoss | WHALE LogLoss |
|---|---|---|---|---|---|
| 视频已见 | 66,894 | 0.759751 | 0.760806 | 0.484103 | 0.482840 |
| 视频未见 | 133,106 | 0.751480 | 0.752955 | 0.451108 | 0.448352 |
| 作者已见 | 170,101 | 0.753606 | 0.754814 | 0.474247 | 0.472500 |
| 作者未见 | 29,899 | 0.750744 | 0.752194 | 0.393289 | 0.388127 |
视频分组和作者分组分别覆盖全部测试目标,两个维度之间存在交叉,不能相加。自然 UNK 分组同时观察了已见与未见编号,有助于理解模型对属性信息和历史关系的使用。
例如,将各视频组的 LogLoss 改善乘以该组占比,再求和,能够恢复整体改善。未见视频组贡献了约 81.28% 的整体 LogLoss 降低。这反映该组的数量与损失差异,不能仅凭这个比例断定某个模块的因果作用。整体 AUC 则无法用组内 AUC 简单加权恢复,因为还存在跨组正负配对。
按视频时长观察,超过 180 秒的分组中 HSTU 的 AUC 和 LogLoss 更好。整体领先仍然需要结合样本构成和具体分组阅读。[7]
11.5 参数数量与计算量怎样区分
五个模型约有 5.54 亿个注册参数,其中 Embedding 参数为 553,893,376 个。WHALE 的非 Embedding 参数为 374,607 个,HSTU 为 253,125 个。[7]
大量参数来自视频和作者的查表表示。以 FP32 计算,全部 Embedding 权重约占 2.06 GiB。训练还需要梯度、优化器状态和中间激活,所以训练显存大于权重文件体积。
训练目标数量除以视频词表大小,不能得到每个视频真实参与学习的次数。历史视频同样参与前向和反向,同一视频也可能在多条目标的历史中重复出现。理解学习频率,需要区分候选出现、历史出现与参数更新。
Embedding 参数数量主要反映词表容量,矩阵运算主要反映稠密计算。二者不能互相替代。当前五模型的实际训练时间和前向矩阵统计为:
| 模型 | 纯训练时间 | 前向矩阵 MFLOPs/目标 |
|---|---|---|
| Wukong | 00:28:14 | 0.401536 |
| HSTU | 01:40:06 | 74.049280 |
| Shallow-hybrid | 00:37:04 | 36.097792 |
| WHALE | 00:43:37 | 40.781259 |
| WHALE MeanPool | 00:37:05 | 39.231616 |
矩阵统计把一次乘加计为两次运算,范围不含查表、归一化、逐元素操作、反向和优化器。全部训练阶段还包括初始化、验证、最终测试和保存,共用时 04:16:24,峰值显存约 10.43 GiB。[7]
HSTU-only 的最大长度为 257,其余历史分支为 128。注意力分数矩阵的元素数量比例为:
这个比例只描述二次项的规模。实际耗时还包括投影、Embedding、时间矩阵生成、数据准备和优化器。相同历史行为数量保证了原始行为信息数量一致,当前 Token 组织与计算量仍然不同。因此,本轮耗时适合描述这些具体配置的成本。
12 从结果理解逐层融合的价值
12.1 与 DIN、DeepFM 的联系
DeepFM 将 FM 的二阶交互与深度网络结合,并共享输入 Embedding。Wukong 延续了显式特征交互的思路,通过层层更新的 Token 表示继续组合信息。[3][9]
DIN 使用候选相关的局部激活单元,为历史行为分配权重。它说明相同用户面对不同候选时,可以读取不同的兴趣证据。[10]
WHALE 同样具有候选相关读取,但 Query 来自已经进行交互的非序列表示,历史先由 HSTU 编码,而且读取在各层重复发生。理解这些联系,有助于说明为什么需要序列关系、特征交互和融合时机三个方面。
DeepFM 和 DIN 没有进入本项目的五模型正式结果表。当前比较集中在 WHALE 对应的分支与融合结构,尚未覆盖传统排序模型的完整比较范围。
12.2 两轮实验提供的认识
早期 1,000,000 条训练目标的实验中,HSTU 的测试 AUC 为 0.740730,WHALE 为 0.739573;WHALE 的 LogLoss 和 NE 最低。这个现象体现了区分能力与概率损失的侧重点:两个指标可以产生不同顺序。
正式配置扩大训练目标,并采用单轮、逐日训练、ID 遮盖和候选参与的 HSTU 输入。五模型的 AUC 均提高,WHALE 为 0.757566。多项条件共同变化,新旧差值评价的是整套配置变化,不能归因于某一个调整。[7]
本轮五个模型使用同一目标集合、同一标签和同一历史来源规则。Wukong 不读取历史,序列模型的使用方式也有差异。共同的数据规则仍然可能对模型产生不同影响,后续结论需要继续限定在当前输入协议中。
12.3 当前结果能够支持的范围
项目完成了真实曝光处理、五模型实现、固定成员训练、测试预测复核和计算成本报告。在当前公开数据与配置下,逐层 Attention Fusion 取得了优于单独分支和两个融合对照的整体指标。这是目前能够直接由保存结果支持的观察。
实验使用一个随机种子,测试成员也曾用于早期比较。尚未测量跨种子的稳定性,没有线上 A/B 测试,因此不能把离线差值解释为线上业务增益。
原 WHALE 论文在工业数据上研究了 3,000~15,000 条历史,并比较接近计算预算下的模型。当前历史上限为 128,使用 2 层和 64 维表示。项目的前向矩阵统计范围也需要与论文计算口径分别理解。[1]
这些条件确定了项目的研究范围:通过可检查的源码与真实结果,理解逐层融合怎样工作,以及它在当前小规模公开数据设置中的表现。规模扩展、统一计算预算和真实服务效率仍然需要各自的证据。
13 参考文献
- Cai 等.WHALE: A Scalable Unified Model for Recommendation with Wukong-HSTU Architecture.RecSys 2026,作者 arXiv v2。
- Liu 等.RecFlow: An Industrial Full Flow Recommendation Dataset.ICLR 2025。
- Zhang 等.Wukong: Towards a Scaling Law for Large-Scale Recommendation.ICML 2024。
- Zhai 等.Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations.ICML 2024。
- Meta.Generative Recommenders:HSTU 参考实现。
- Loshchilov、Hutter.Decoupled Weight Decay Regularization.ICLR 2019。
- WHALE-RecFlow:源码、正式配置与完整汇总结果。本文实验数值对应配置版本 3。
- Scikit-learn.ROC AUC 指标说明。
- Guo 等.DeepFM: A Factorization-Machine based Neural Network for CTR Prediction.IJCAI 2017。
- Zhou 等.Deep Interest Network for Click-Through Rate Prediction.KDD 2018。
评论由 GitHub Giscus 提供。若当前网络无法加载,可 前往 GitHub Discussions 查看或参与讨论。