RankMixer 详解(2):Sparse MoE、规模扩展与实验设计
阅读依据:Jie Zhu、Zhifang Fan、Xiaoxie Zhu 等,RankMixer: Scaling Up Ranking Models in Industrial Recommenders,arXiv:2507.15551v3[1]。模型输入和 Dense Block 的逐步计算见 上篇。
1 将独立 FFN 扩展为 Sparse MoE
1.1 容量与每次请求的计算预算
Dense RankMixer 为每个 Token 分配一个 FFN(前馈网络)。一次前向计算会执行这些网络的全部主要权重乘法。随着模型扩大,权重存储和计算量都会增加。
Sparse MoE(稀疏专家混合)为每个位置准备多个专家。每个专家本身就是一个 FFN。Router(路由器)根据当前 Token 分配计算权重,仅执行具有正权重的专家,再把它们的输出相加。
这使总参数量与单个请求使用的参数量可以分别安排。所有专家仍需要保存,每个请求则只使用其中一部分。专家数量增加时,也要考虑显存、路由、数据移动和并行调度的成本。
沿用上篇的符号, 是混合和归一化后的 Token, 是第 个 Token 的第 个专家。 表示 Token 数量, 表示每个 Token 的专家数量,对应前文的 和规模扩展中的 。
同一个位置的专家接收同一个 。不同位置拥有各自的专家参数。模型章节用 表示专家输入,前面的 Dense Block 则使用 。当直接替换 PFFN 时,专家输入与输出仍要保持 维,才能执行后面的残差连接。
1.2 ReLU Routing 怎样选择专家
路由器 为每个专家产生一个分数。把第 个分数送入 ReLU,得到门值[1]:
公式(10)中的 是一组专家分数。写出 ,能够明确每个门值取自哪个分量。混合输出为:
正分数对应活跃专家。负分数和零分数得到门值 0。各门值直接参与加权,公式没有规定它们相加等于 1。输入信息改变时,一个 Token 可以使用一个专家,另一个 Token 可以使用多个专家。
Top-k 路由通常预先限定每个 Token 使用的专家数量。ReLU Routing 允许数量随输入变化,使计算预算可以在 Token 之间分配。这里的“更多专家”由训练后的分数决定。信息的重要性需要通过任务损失学习。
Top-k 可以理解为一次排名选择。路由器为全部专家计算分数,softmax 将分数转换成概率,再保留得分最高的若干专家。即使两个专家的得分非常接近,名次交换也可能改变参与计算的专家集合。任务梯度需要经过被选择的路径传播。
ReLU 根据分数是否为正决定参与范围。某个分数从负值增加到很小的正值时,专家输出先乘以这个很小的门值,再加入结果。只要专家输出有限,这一贡献就在跨越零点时连续变化。ReLU 在零点具有导数边界,其两侧的传播规则分别确定。这个性质是 ReMoE 使用 ReLU Routing 的动机之一[2]。
门值也会改变输出的尺度。例如,两个门值都增加到原来的 2 倍,对应的加权输出也增加到 2 倍。后面的残差相加、LN 和 L1 正则会继续影响这条路径。因此,活跃专家数量相同的两个 Token,仍然可以得到不同的加权响应。
从梯度也能理解路由和专家怎样共同学习。设输出 收到梯度 。活跃专家的参数 收到:
门值越小,这条任务梯度的权重也越小。门值为 0 时,专家通过这一输出路径收到的任务梯度为 0。长时间获得较少训练信号的专家,难以学到有用的变换。
1.3 L1 正则怎样控制活跃程度
训练目标在任务损失之外增加门值的 L1 正则:
所有 都非负,因此门值之和就等于 L1 范数。 控制门值的训练成本。对于正路由分数 :
任务项会鼓励有用的专家,正则项则增加正门值的成本。两者共同决定哪些分数维持为正。负分数位于 ReLU 的平坦区,通过这条路径的梯度为 0,专家和路由的训练覆盖因此需要特别安排。
正则计算的是门值幅度。活跃专家数量计算的是 。许多很小的正门值,也可能对应较多活跃专家。因此,维持平均活跃比例还需要预算反馈和 的调整。公开说明给出了自适应惩罚的方向,未给出完整更新规则。
1.4 平均计算预算怎样参与训练反馈
预算控制需要同时观察正则强度和实际活跃数量。用 表示第 次更新时,批次内的平均活跃专家比例。若共有 条样本,可以统计:
设目标比例为 。活跃比例高于目标时,可以提高 ,增加正门值的成本;低于目标时,可以降低惩罚,让任务损失更容易保留有用专家。
ReMoE 给出了一种具体的乘法更新[2]。将它的零值比例改写为这里的活跃比例,得到:
例如,目标比例为 1/4,当前比例为 0.4, 乘以 ;当前比例为 0.15,则除以 。比例相同时保持原值。这里的 控制每次调整的幅度,避免一次调整幅度过大导致预算反复波动。
这项补充用于解释自适应惩罚的计算含义。RankMixer 给出了预算与惩罚系数的关系,未公开工业训练采用的完整更新规则。ReMoE 的正则还包含平均与负载相关的设置,复现时需要连同其损失定义使用。
平均预算允许各个 Token 使用不同数量的专家。某一行可以激活 3 个,另一行激活 1 个,只要整体比例接近目标。它也允许某些样本使用更多计算。因此,统计平均值之外,还需要观察各个位置的分布和单次请求的计算量。
1.5 Dense-training / Sparse-inference 的两个路由器
DTSI-MoE(训练时充分使用专家、推理时稀疏使用专家)采用 和 两个路由器。二者都在训练阶段更新, 只约束 。上线推理使用 [1]。
训练路由承担更充分的专家学习。推理路由在专家已经获得训练信号的基础上,学习满足服务预算的选择方式。这样,专家训练覆盖与上线计算预算分别受到控制。
专家质量依赖它收到多少有效更新。假设每个位置有 8 个专家,一个批次包含 512 条样本。如果均匀分配且每条样本激活 1 个专家,每个专家平均只处理 64 条;若每条样本让全部专家参与,每个专家就能处理 512 条。这个计数例子说明训练覆盖为何会随着稀疏程度改变,具体更新还受到门值和任务梯度的影响。
双路由希望让推理选择发生在已经获得充分训练的专家之间。训练阶段可以投入更多计算,推理阶段则控制每条请求的成本。两者的预算分别安排后,增加专家容量才更容易转化为有效的预测能力。
这一策略的关键细节是两个路由器怎样共同训练。公开描述没有完整给出双路由任务损失、梯度合并方式和训练路由的具体门函数。因此,可以确认两个路由器的角色、正则作用对象和推理路径;严格复现时,还需要补齐这些设置。也不能仅凭训练路由没有 L1 惩罚,就推断所有专家在每条样本上都会激活。
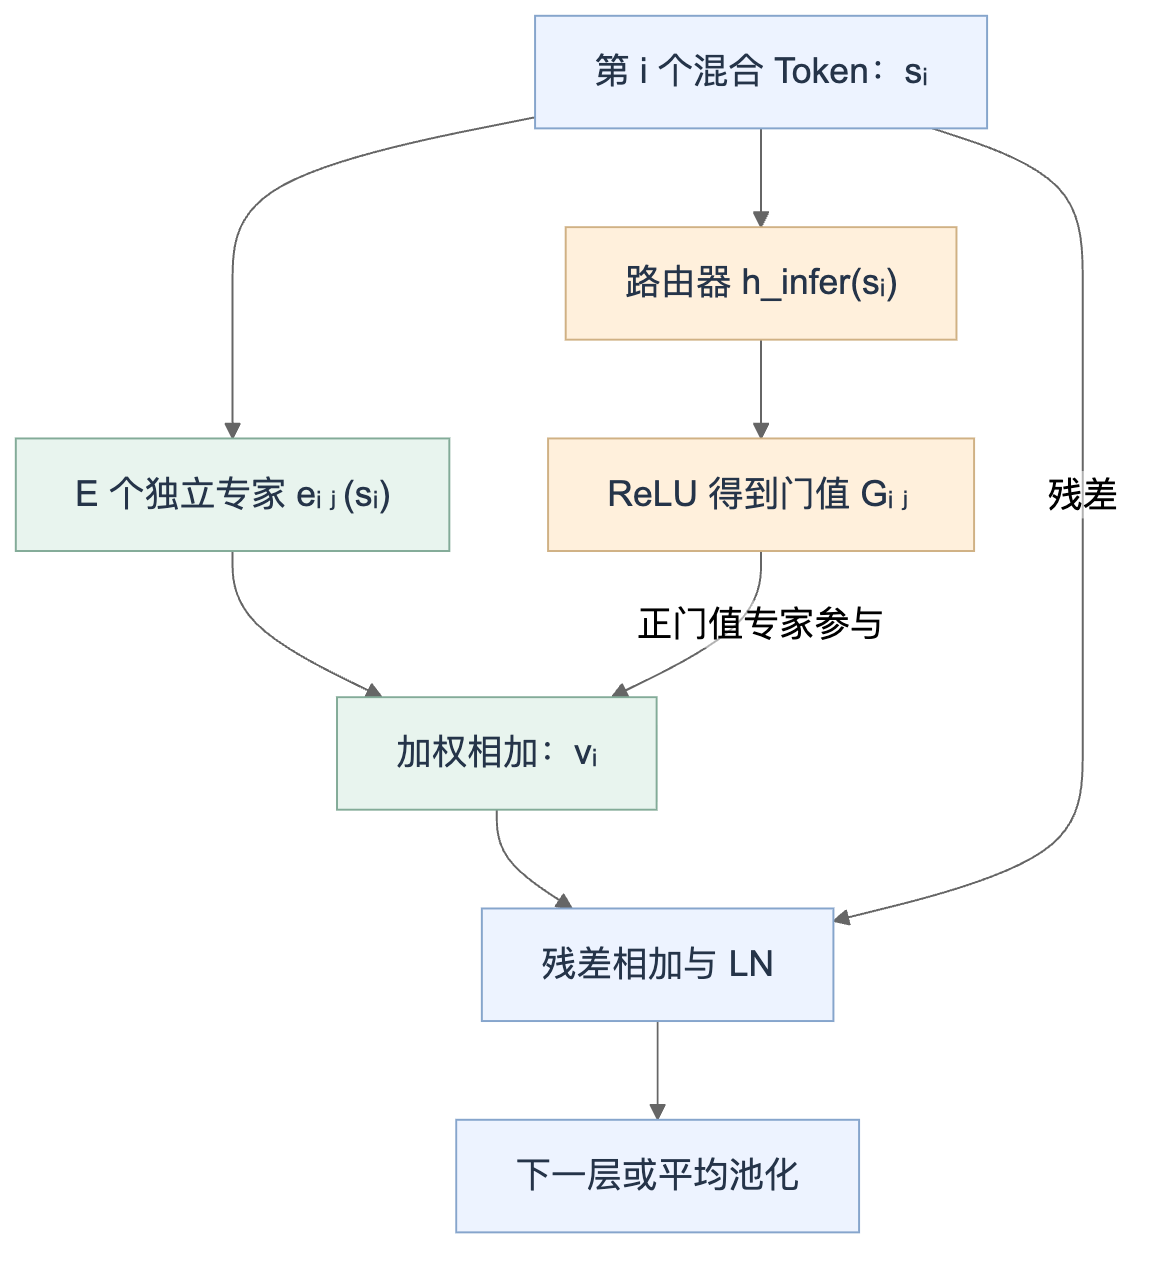
图示根据公式(10)绘制。它展示推理路由,多个 Token 按位置分别执行[1]。
2 模型规模怎样增加
2.1 参数量与前向 FLOPs 的推导
对于单个 Token 的两层 FFN,两个主要权重矩阵各有 个参数。 个 Token、 层的参数量为[1]:
计算一个 的矩阵乘法,需要约 次乘法与同等数量的加法。两个线性层合计约 次浮点运算。因此,单条样本的前向计算量为:
这两个近似式统计 PFFN 的主要矩阵。bias、LN、激活、输入投影、预测层和 Embedding 分别具有额外成本。参数数量中的 Dense-Param(稠密部分参数)还需要与稀疏 Embedding 参数区分。
四个扩展方向的影响如下:
| 扩展方向 | 主要参数与 FLOPs 的变化 | 还会改变什么 |
|---|---|---|
| 增加到 2 倍 | 增加到约 2 倍 | 分组粒度、独立参数组数量和并行组织 |
| 增加到 2 倍 | 增加到约 4 倍 | 矩阵形状和每个 Token 的表示容量 |
| 增加到 2 倍 | 增加到约 2 倍 | 连续计算阶段和信息交换次数 |
| 增加到 2 倍 | 专家总参数增加到约 2 倍 | 每次请求的计算由活跃专家数决定 |
增加 时,输入组织也要相应设置。采用 后, 需要能被新的 整除。增加 常能形成较大的矩阵乘法;增加 则增加依次执行的阶段。相同的理论 FLOPs,在 GPU 上可能具有不同执行时间。
2.2 Sparse MoE 的总容量与活跃容量
设每个位置有 个同等大小的专家,总专家参数约为:
沿用稀疏比例的定义:
主要的活跃参数与前向计算量约为:
这里的 可以表示整个批次的平均比例。ReLU Routing 允许各个 Token 的活跃数量不同。若每个位置有 8 个专家、平均激活 1 个,,主要 FFN 计算约等于每个位置执行一个 FFN。
减少活跃比例会减少专家乘法,但全部专家的权重仍要保存。服务成本还取决于权重访问、分配到不同设备的方式和批次形状。计算比例与最终吞吐量,需要分别衡量。
3 工业实验怎样设置
3.1 数据、目标和训练方式
离线数据来自 Douyin 推荐系统的日志与反馈。设置中包含超过 300 个字段,涉及数值、ID、交叉和行为序列特征。用户 ID 达到十亿量级,视频 ID 达到亿级。数据说明使用万亿级日记录量,实验使用两周收集的数据[1]。
这些数字描述工业数据规模。训练、验证、测试各自使用多少条记录,以及时间边界、采样比例和重复次数,没有完整列出。因此,万亿级记录量与模型最终读取的训练样本总数需要分别理解。
Finish 标签表示是否完成观看,Skip 标签表示是否在短时间内划向下一条内容。两个目标分别评估。处于中间观看时长的记录如何定义,短时间阈值如何选择,需要具体的标签设置。
训练使用数百张 GPU。稀疏 Embedding 部分采用异步更新,Dense 部分采用同步更新。Dense 部分使用 RMSProp,学习率为 0.01;稀疏部分使用 Adagrad。各模型的优化器超参数保持一致。
稀疏与稠密部分采用不同更新方式,是因为前者通常只访问大量编号中的一小部分,后者每次执行主要矩阵计算。同步更新使 Dense 参数由共同的批次梯度更新;异步更新则允许稀疏参数处理分散的访问。
训练 FLOPs/Batch(每个批次的训练浮点运算次数)使用 512 条样本的口径。这个口径包含训练计算;公式(12)描述单条样本的主要前向计算。二者比较时,还需要反向计算和统计范围。
3.2 RMSProp 与 Adagrad 怎样更新参数
两种优化器都根据各个参数收到的梯度调整更新幅度。下面说明常见形式,使用 表示更新次数, 表示当前梯度, 表示学习率。平方、除法与平方根都逐个参数坐标计算。
Adagrad 累积历史梯度的平方:
一个坐标如果长期收到较多梯度, 通常较大,后续有效步长随之减少。很少被访问的 Embedding 行,历史累积可能较小,仍能保留较大的有效步长。这个性质适合说明 Adagrad 在稀疏特征学习中的作用[3]。
RMSProp 使用平方梯度的指数移动平均:
控制历史梯度保留多久。它让较早的梯度逐步减少影响,使步长能够跟随近期训练状态调整[4]。RankMixer 报告 Dense 部分学习率为 0.01,未完整列出 、 与其他优化器设置。
同步与异步描述更新组织方式。Dense 参数由多台设备汇总梯度,再共同更新。稀疏参数按实际访问的编号传递更新,可以减少处理完整参数表的成本;不同设备读取参数的时间也可能不同。优化器和同步方式分别决定更新幅度与更新时机。
各个模型使用相同优化器设置,有助于控制实验条件。相同设置下的成绩说明这一组条件中的表现。判断每种结构的最佳能力,还要考虑它各自的超参数搜索范围、收敛情况与训练成本。
3.3 各个对照模型在学习什么
DLRM-MLP 与 MoE:检验通用网络的容量。 这里的 DLRM-MLP 基线,将编码后的特征交给普通 MLP。隐藏单元通过加权和与激活学习组合关系。MoE 增加多个并行专家,再由门函数汇总结果。它们提供通用的容量扩展方式,可以检验专门设计输入交互结构是否带来额外收益。
DCNv2:显式产生乘法交互。 把它的输入写成列向量 ,一个 Cross Layer(交叉层)的形式为:
先汇总当前表示,再与原始输入逐坐标相乘。第一层由此产生原始坐标之间的乘积。后续层继续乘以 ,能够增加显式交互的阶数。完整矩阵让不同坐标拥有更灵活的交叉权重,低秩分解则将大型矩阵表示为两个较窄矩阵,减少参数和乘法[5]。
RDCN:在交叉结构中加入 Attention。 LiRank 的 Residual DCN 在低秩交叉计算中加入注意力和残差路径[6]。Attention 改变压缩表示之间的组合权重,残差帮助已有信息继续参与计算。这个基线检验在显式交叉内部增强信息选择的效果。
AutoInt 与 HiFormer:学习样本相关的信息汇总。 AutoInt 用 Multi-Head Self-Attention,让字段按照相关分数汇总其他字段的信息。连续执行多个交互层,已经组合的表示继续参与下一层汇总[7]。HiFormer 从异构字段的独立投影出发,再通过 Composite Projection(组合投影)生成包含多个字段的信息表示,并采用低秩近似控制成本[8]。这两项基线检验可学习汇总与异构表示处理。
DHEN:组合多种交互方法。 DHEN 在一层中并行执行多个交互模块,再通过拼接、求和或加权汇总组织结果。下一层继续处理这些结果,可以学习不同交互方法之间的关系[9]。这个设计同时需要考虑模块本身的成本和组合后的表示形状。
Wukong:反复处理显式交互结果。 Wukong 的 Factorization Machine Block(因子分解机模块)计算向量之间的内积,再用 MLP 将结果转换为新向量。Linear Compress Block(线性压缩模块)保留经过线性组合的信息。两种输出拼接后,进入下一层。多个交互阶段让此前的组合继续参与新的组合[10]。
Wukong 还通过低秩投影减少内积矩阵的成本[10]。例如, 可以按 计算。若 的列数较少,就能够减少中间矩阵的大小和运算次数。这说明扩展研究同时关注表示能力与执行方式。
这些方法分别改变交互路径、参数分配或计算组织。阅读 Table 1 时,应该把预测质量与这些结构目的联系起来,并同时查看每种配置的参数量和 FLOPs。
3.4 AUC 与 UAUC 分别衡量什么
AUC(ROC 曲线下面积)可以理解为:随机取一条正样本和一条负样本,正样本得分更高的概率。并列得分按半次正确排序计算:
全局 AUC 的比较可能跨越不同用户。用户之间的基础行为概率不同,因此还要观察 UAUC(User-level AUC,用户层面的 AUC)。它在每个用户内部计算 AUC,再进行汇总。
常见的加权表达为:
包含同时拥有正负标签的用户。全部标签相同的用户,无法计算用户内部的正负排序。汇总可以采用等权,也可以按照记录数量设置 。具体的权重和无效用户处理方式,没有在实验设置中给出。
理解两个指标时,要同时考虑全局行为概率与同一个用户的内容排序。两者共同改善,能够支持模型在多个层面获得收益。
设置说明将 AUC 增加 0.0001 视为具有显著意义的改进。这个数值描述指标变化,统计判断还需要实验样本数量、变化范围和检验方法。评估一次独立实验时,需要同时提供这些信息。
4 基线比较与规模扩展结果
4.1 Table 1 中的预测质量
下面保留 Table 1 的全部结果。基线行是绝对指标,其他行是相对基线报告的增益。空缺表示未报告。
| 模型 | Finish AUC | Finish UAUC | Skip AUC | Skip UAUC |
|---|---|---|---|---|
| DLRM-MLP 基线 | 0.8554 | 0.8270 | 0.8124 | 0.7294 |
| DLRM-MLP-100M | +0.15% | 未报告 | +0.15% | 未报告 |
| DCNv2 | +0.13% | +0.13% | +0.15% | +0.26% |
| RDCN | +0.09% | +0.12% | +0.10% | +0.22% |
| MoE | +0.09% | +0.12% | +0.08% | +0.21% |
| AutoInt | +0.10% | +0.14% | +0.12% | +0.23% |
| DHEN | +0.18% | +0.26% | +0.36% | +0.52% |
| HiFormer | +0.48% | 未报告 | 未报告 | 未报告 |
| Wukong | +0.29% | +0.29% | +0.49% | +0.65% |
| RankMixer-100M | +0.64% | +0.72% | +0.86% | +1.33% |
| RankMixer-1B | +0.95% | +1.22% | +1.25% | +1.82% |
来源:Table 1[1]。百分比的换算口径没有进一步说明,所以这里保留报告格式。以 +0.64% 为例,若表示相对增幅,0.8554 应乘以 1.0064;若表示增加 0.64 个百分点,则应加上 0.0064。直接换算成新的绝对 AUC,需要确认所用定义。
RankMixer-100M 的四项报告增益均高于表中的其他基线。RankMixer-1B 在四项指标上继续提高,说明增加规模在这一设置中具有收益。
4.2 参数和计算预算怎样比较
模型容量与训练成本分别列在下表。M 表示百万,B 表示十亿;G 表示十亿次运算,T 表示万亿次运算。
| 模型 | Dense 参数 | 训练 FLOPs/Batch |
|---|---|---|
| DLRM-MLP 基线 | 8.7 M | 52 G |
| DLRM-MLP-100M | 95 M | 185 G |
| DCNv2 | 22 M | 170 G |
| RDCN | 22.6 M | 172 G |
| MoE | 47.6 M | 158 G |
| AutoInt | 19.2 M | 307 G |
| DHEN | 22 M | 158 G |
| HiFormer | 116 M | 326 G |
| Wukong | 122 M | 442 G |
| RankMixer-100M | 107 M | 233 G |
| RankMixer-1B | 1.1 B | 2.1 T |
“100M”比较覆盖了不同容量的模型。DCNv2、AutoInt 和 DHEN 的参数量明显小于 100 M。RankMixer-100M、HiFormer 和 Wukong 则较为接近。表格提供了多个结构的质量与成本,精确的等参数、等 FLOPs 结论还要采用匹配配置。
与 Wukong 的表中配置相比,RankMixer-100M 的参数为 107 M,训练计算为 233 G,同时具有更高的四项增益。与 DLRM-MLP-100M 相比,它也提高了指标,计算则从 185 G 增加到 233 G。模型比较需要同时读取这两类数字。
下面的组件可以切换目标,查看报告增益与资源使用。它保留每个模型的真实配置,未报告的指标会保持空缺。
4.3 Figure 2 的规模曲线说明了什么
规模实验沿 、 和 调整模型。Figure 2 分别以参数量和 FLOPs 为横轴,展示 Finish AUC 增益;横轴采用对数尺度[1]。同一个横轴距离因此表示相同的倍数变化。
RankMixer 在这组测量范围内保持较高增益。Wukong 的参数曲线也有增长,但计算成本增加更快;DHEN 的扩展收益相对有限。只比较参数曲线,会遗漏执行同等质量所需的计算。
不同扩展方向在相近总参数下,得到接近的质量。实际配置进一步考虑执行效率,采用 的 100M 配置,以及 的 1B 配置。
较大的宽度可以扩大矩阵乘法形状,帮助 GPU 使用计算单元。层数增加则会增加连续执行阶段。选择这两组配置,同时考虑了质量和执行方式。
这里呈现的是测量范围内的扩展规律。图中未给出可直接复用的幂律拟合系数和置信区间。 和各模块的完整参数统计也未全部公开,仅靠 无法精确复算 107 M 和 1.1 B。
5 消融实验怎样检验结构设计
5.1 移除组件的结果
Table 2 在 RankMixer-100M 上改变组件,其余部分尽量保持比较条件。结果相对于完整结构报告:
| 设置 | 报告的 ΔAUC | 检验的问题 |
|---|---|---|
| 移除残差连接 | -0.07% | 保留输入路径是否有帮助 |
| 移除 Multi-Head Token Mixing | -0.50% | 跨 Token 信息交换是否有帮助 |
| 移除 LayerNorm | -0.05% | 数值尺度控制是否有帮助 |
| 独立 FFN 改为共享 FFN | -0.31% | 独立参数分配是否有帮助 |
来源:Table 2[1]。移除 Token Mixing 的损失最大。各 FFN 只处理各自的信息,跨来源的交换能力减少。共享 FFN 也降低了效果,支持独立参数分配在该设置中的作用。
残差和 LN 的变化说明完整 Block 的组织方式影响结果。这个表格报告最终 AUC,训练中的梯度大小和数值波动没有单独给出。结构作用的解释可以来自计算关系,具体训练稳定性的程度仍需训练记录。
共享 FFN 的参数容量会同时变化。它在固定宽度下需要保存更少权重,因此这项实验检验的是整项替换效果。若要单独判断“独立分配”在相同参数量下的贡献,还要补充容量匹配的配置。
5.2 Token 到 FFN 的三种路由对照
Table 3 检验不同信息组织方式,相对于 Multi-Head Token Mixing 报告:
| 路由方式 | ΔAUC | ΔParams | ΔFLOPs |
|---|---|---|---|
| All-Concat-MLP | -0.18% | 0.0% | 0.0% |
| All-Share | -0.25% | 0.0% | 0.0% |
| Self-Attention | -0.03% | +16% | +71.8% |
来源:Table 3[1]。All-Concat-MLP 将全部 Token 拼接,交给一个大型 MLP,再恢复为多个 Token。它检验集中处理全部输入的方式。
All-Share 将整个输入交给各个 FFN,检验每个 FFN 都看到相同完整输入的方式。它与共享 FFN 是两项设置:前者改变输入的分配,后者改变参数的共享。
Self-Attention 使用样本相关的注意力进行信息交换。它的 AUC 略低,参数和 FLOPs 则分别增加 16% 和 71.8%。这一结果支持固定重排在当前数据和配置中的质量与效率。
这些对照比较的是特定任务中的架构选择。异构输入之间学习有效的内积关系需要投影与训练,其效果取决于数据规模和模型配置。
5.3 Sparse MoE 的稀疏比例与专家训练
Figure 3 比较活跃比例为 1、1/2、1/4 和 1/8 时的 AUC。对照包括普通 Sparse MoE、加入负载均衡损失的版本,以及 DTSI 与 ReLU Routing 的组合。
普通 Sparse MoE 随活跃比例减少而降低质量。负载均衡损失改善了部分退化。DTSI 与 ReLU Routing 的组合在较低活跃比例下,接近 1B Dense 模型的效果,并报告了超过 50% 的吞吐量提升。
负载均衡鼓励专家获得更均匀的使用机会,DTSI 则直接关注专家是否获得足够训练。一个专家使用次数较少,可能源于路由分配;如果训练信号本身不足,仅调整使用分布也可能难以解决。
Figure 4 展示不同 Token 在两层中的活跃比例。各 Token 的比例有所不同,说明动态路由可以分配不同的计算预算。它展示的是位置之间的活跃情况。逐个专家的使用次数、训练覆盖和长期变化,还需要另外统计。
10B 规模在这里是扩展方向。完整上线数据和服务成本表采用 RankMixer-1B,Sparse MoE 的扩展实验与线上模型需要分别阅读。
5.4 负载均衡损失怎样影响专家使用
负载均衡关注专家之间的使用分布。以常见的 Top-1 路由为例,设每次选择一个专家, 是批次内被分配给专家 的 Token 比例, 是该专家的平均路由概率。Switch Transformers 使用的辅助项可以写成[11]:
这里省去了辅助项系数。 来自离散选择,训练通常通过可求导的 传播这个辅助项的梯度。使用比例较高的专家,对增加其路由概率会产生更大的惩罚,推动路由器把机会分配给其他专家。
例如,两个专家均匀使用,且 时,辅助项为 1。若 ,辅助项为 1.64。这个例子展示同一损失如何对较集中的使用增加训练成本。
RankMixer 的实验包含加入负载均衡损失的对照,未明确给出该对照的完整损失公式。上述表达用于理解常见方法的工作方式。ReLU Routing 允许多个专家同时活跃,其活跃次数和门值也需要按对应定义统计。
负载分布、总计算预算和专家训练覆盖,分别回答不同问题。各个专家是否均匀使用,需要观察使用次数;一次请求执行多少计算,需要观察活跃专家数量;专家是否学得充分,需要观察有效梯度和训练进度。Figure 3 中增加负载均衡与采用 DTSI 的效果[1],应当联系这三种统计理解。
6 参数扩大后的服务成本
6.1 MFU 与延迟的关系
MFU(Model FLOPs Utilization,模型浮点运算利用率)比较有效模型计算速度与所用硬件的理论计算能力。设一次计算需要 次浮点运算,耗时为 ,匹配统计范围的理论峰值为 :
再用 ,得到成本说明中的表达:
分子是运算次数,分母是每秒可执行的有效运算次数,所以结果具有时间单位。参数数量、每个参数对应的计算次数、资源使用效率和精度模式,会共同影响执行时间。
这个关系解释模型计算成本。服务中的排队、通信、Embedding 读取、批次组织和其他算子也会影响请求延迟。实际延迟仍以服务测量为准。
6.2 Table 6 中的三项执行技巧
| 指标 | OnlineBase-16M | RankMixer-1B |
|---|---|---|
| Dense 参数 | 15.8 M | 1.1 B |
| 报告的 FLOPs | 107 G | 2,106 G |
| FLOPs/Param(G/M) | 6.8 | 1.9 |
| MFU | 4.47% | 44.57% |
| 计算精度 | fp32 | fp16 |
| 延迟 | 14.5 ms | 14.3 ms |
来源:Table 6[1]。由列出的数值计算,参数约增加到 69.6 倍,FLOPs 约增加到 19.7 倍。两种增长幅度不同,是因为每个参数对应的运算次数也发生了变化。
计算组织。 独立 FFN 允许扩大参数容量,并将大量计算放入矩阵乘法。每个参数对应的计算量从 6.8 降到 1.9,约减少 72%。
并行执行。 大型 GEMM(通用矩阵乘法)与并行 FFN 的融合执行,减少小算子调度和内存传输成本。MFU 从 4.47% 增加到 44.57%,有效计算资源使用约增加到 10 倍。
精度模式。 fp16(半精度浮点数)降低部分计算和存储成本。在这一部署说明中,采用 fp16 后的理论计算能力按增加到 2 倍估算。具体 GPU 和算子的速度仍依赖设备测量。
大型 GEMM 的优势还来自数据复用。一次读取的输入块与权重块,可以在计算单元附近用于多次乘法。Batch 增大时,同一组 FFN 权重也能够处理更多样本。相比之下,大量短小计算会重复承担调度和数据传输的固定成本。
算子融合把能够连接的运算共同执行,减少中间结果写入显存后再次读取的次数。它通常保持数学上的计算目标,但具体浮点执行顺序可能改变。理解延迟时,需要同时关注有效乘法、数据读取和调度次数。
fp16 用较少位数保存数值,也具有不同的精度和数值范围。具体计算可以结合更高精度的累加与统计操作,以控制误差。Table 6 没有列出所有算子的精度安排,因此其结果说明的是整套服务配置。计算 MFU 时,理论峰值也需要与实际精度模式和设备数量匹配。
把约 19.7 倍的 FLOPs 增长,除以约 10 倍的 MFU 增长和 2 倍的理论能力,得到接近 1 的计算时间比例。这与表中 14.5 ms、14.3 ms 的延迟关系一致。
因此,相近延迟依赖模型结构、并行执行和精度模式共同作用。仅增加参数,或仅采用 fp16,都不足以推出同样的结果。
7 线上 A/B 测试怎样解释
7.1 两个推荐应用的结果
线上比较采用既有的 DLRM 与 DCN 组合模型作为基线,替换其 Dense 部分。推荐场景覆盖 Douyin 和 Douyin Lite。Table 4 的结果来自长期 A/B 观察,说明中给出 8 个月的观察期,数据更新截至 2025 年 7 月 24 日。
Active Day 表示实验期内每个用户的平均活跃天数。Duration 表示应用使用时长。Like、Finish 和 Comment 分别统计点赞、完整播放和评论行为。下列百分比保留表中相对变化的格式。
A/B 测试希望比较相同条件下采用不同模型的结果。通常将用户随机分配到实验组和对照组,保持分组稳定,再统计同一观察期内的行为。若某项人均指标分别为 和 ,相对变化为:
随机分组使用户原有差异更容易在两组间平均分配。对同一用户的多次行为,统计时还需要考虑它们之间的相关性。这些是理解 A/B 结果的一般方法,表格本身没有完整公开分流与显著性计算流程。
| Douyin 用户组 | Active Day | Duration | Like | Finish | Comment |
|---|---|---|---|---|---|
| 全部 | +0.2908% | +1.0836% | +2.3852% | +1.9874% | +0.7886% |
| 低活跃 | +1.7412% | +3.6434% | +8.1641% | +4.5393% | +2.9368% |
| 中活跃 | +0.7081% | +1.5269% | +2.5823% | +2.5062% | +1.2266% |
| 高活跃 | +0.1445% | +0.6259% | +1.8280% | +1.4939% | +0.4151% |
| Douyin Lite 用户组 | Active Day | Duration | Like | Finish | Comment |
|---|---|---|---|---|---|
| 全部 | +0.1968% | +0.9869% | +1.1318% | +2.0744% | +1.1338% |
| 低活跃 | +0.5389% | +2.1831% | +4.4486% | +3.3958% | +0.9595% |
| 中活跃 | +0.4235% | +1.9011% | +1.7491% | +2.6568% | +0.6782% |
| 高活跃 | +0.0929% | +1.1356% | +1.8212% | +1.7683% | +2.3683% |
来源:Table 4[1]。两个应用的整体指标都提高,低活跃组的多项相对增幅较大。这支持模型在既有流量中获得了业务收益。
低活跃组的相对增幅,还受到原有活跃水平的影响。基础值较小,相同的绝对增加会产生较大的相对百分比。判断新增了多少活跃天数,还需要各组的基线均值和人数。
长期反向 A/B 实验保留一部分用户继续使用旧模型,观察新模型收益是否维持。它有助于区分短期波动与持续变化。统计显著性来自实验报告;公开表格没有列出各组样本数量、随机分流单位、置信区间和检验过程。
7.2 广告场景的收益
广告实验的 Table 5 报告 AUC 增益 +0.73%,ADVV(Advertiser Value,广告主价值)增益 +3.90%[1]。前者衡量模型质量,后者衡量广告业务结果。
推荐与广告两个场景都使用 RankMixer-1B,支持该主体结构具有跨场景的应用能力。收益幅度仍由对应的数据、任务、服务设置和实验人群共同决定。
8 用数字理解专家预算与评估指标
8.1 两个 Token 的 ReLU 路由
构造一个便于手算的例子:两个 Token,每个 Token 有四个专家。给定推理路由分数:
经过 ReLU:
第一个 Token 使用两个专家,第二个 Token 使用一个专家。总共激活 3 个专家实例,在 8 个可用实例中占 。门值之和则为 。这个例子直接显示了活跃数量与 L1 正则的区别。
给定第一个 Token 的活跃专家输出:
加权结果为:
若 ,则 。之后把 加回 ,执行 LN,再进入下一层或平均池化,后续流程与上篇保持一致。
若任务损失为 0.4,,则这个例子的总损失为 。这里的分数、专家输出和任务损失均为明确给定的算术示例,用于理解公式。
下面的组件跟踪第一个 Token,初始门值之和为 0.7,总损失为 0.47。修改门分数和 ,可以实时核对活跃数量、混合输出和总损失。
8.2 相同 FFN 预算下怎样增加容量
设置 ,Dense PFFN 的主要参数为:
单条样本前向计算为 4,096 FLOPs。若每个位置扩展为四个专家,总专家参数变为 8,192。平均每个位置激活一个专家时,,主要前向计算仍约为 4,096 FLOPs。
这个计算把权重总容量增加到 4 倍,同时维持主要专家乘法预算。额外的路由计算和权重存储需要继续计入运行成本。它对应 Sparse MoE 的容量与计算分配关系。
8.3 全局 AUC 与用户内部 AUC
考虑两个用户,每个用户都有一条正记录和一条负记录:
| 用户 | 正样本预测 | 负样本预测 | 用户内部 AUC |
|---|---|---|---|
| A | 0.2 | 0.1 | 1 |
| B | 0.9 | 0.8 | 1 |
每个用户内部,正样本都排在负样本之前,等权 UAUC 为 1。全局比较包含四对正负记录:0.2 与 0.1、0.2 与 0.8、0.9 与 0.1,以及 0.9 与 0.8。其中三对正确,全局 AUC 为 。
这组给定数字展示了用户基础概率的差异如何影响全局指标。阅读 Finish 和 Skip 的实验结果时,同时检查 AUC 与 UAUC,才能了解模型对整体排序和用户内部排序的影响。
9 参考文献
- Jie Zhu、Zhifang Fan、Xiaoxie Zhu 等。2025。RankMixer: Scaling Up Ranking Models in Industrial Recommenders。arXiv:2507.15551v3。
- Ziteng Wang、Jianfei Chen、Jun Zhu。2024。ReMoE: Fully Differentiable Mixture-of-Experts with ReLU Routing。arXiv:2412.14711v1。
- John Duchi、Elad Hazan、Yoram Singer。2011。Adaptive Subgradient Methods for Online Learning and Stochastic Optimization。Journal of Machine Learning Research,12:2121~2159。
- PyTorch Contributors。RMSprop。PyTorch 2.10 文档。
- Ruoxi Wang、Rakesh Shivanna、Derek Z. Cheng 等。2021。DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems。The Web Conference 2021。
- Fedor Borisyuk、Mingzhou Zhou、Qingquan Song 等。2024。LiRank: Industrial Large Scale Ranking Models at LinkedIn。KDD 2024。
- Weiping Song、Chence Shi、Zhiping Xiao 等。2019。AutoInt: Automatic Feature Interaction Learning via Self-Attentive Neural Networks。CIKM 2019。
- Huan Gui、Ruoxi Wang、Ke Yin 等。2023。Hiformer: Heterogeneous Feature Interactions Learning with Transformers for Recommender Systems。arXiv:2311.05884。
- Buyun Zhang、Liang Luo、Xi Liu 等。2022。DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction。arXiv:2203.11014。
- Buyun Zhang、Liang Luo、Yuxin Chen 等。2024。Wukong: Towards a Scaling Law for Large-Scale Recommendation。ICML 2024。
- William Fedus、Barret Zoph、Noam Shazeer。2021。Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity。arXiv:2101.03961。
评论由 GitHub Giscus 提供。若当前网络无法加载,可 前往 GitHub Discussions 查看或参与讨论。