阅读依据:Jie Zhu、Zhifang Fan、Xiaoxie Zhu 等,RankMixer: Scaling Up Ranking Models in Industrial Recommenders,ByteDance,arXiv:2507.15551v3,2025 年 7 月 26 日[1]。
1 排序模型中的特征交互
用户打开推荐页面时,排序模型需要判断每个候选内容是否值得展示。输入通常包含用户 ID、内容 ID、用户资料、历史行为、当前场景和用户与内容的关系。模型输出完成观看、快速划走、点赞等行为的预测结果。
单个特征只能提供部分信息。一个用户喜欢科幻电影,需要结合候选电影的类型才能帮助预测;近期观看历史与长期兴趣也可能表达不同的信息。特征交互,就是学习这些信息共同出现时与目标行为的关系。
RankMixer 处理的是经过编码的特征向量。历史行为序列可以通过前面的 Sequence Module(序列处理模块)得到 es,随后作为一个特征来源进入主体网络。序列长度和 RankMixer 的 Token 数量分别属于不同阶段。
这里的 Token 表示一组特征的向量。它可以包含多个字段,也可以来自一个语义组中的一段向量。用户 ID 和视频 ID 的编号空间各自独立。两个编号相同,也无法据此判断它们具有相同含义。
模型需要同时满足预测质量和服务速度。GPU(图形处理器)适合执行大型矩阵乘法。推荐模型中的大量小算子、数据读取和重复调度,会限制计算资源的使用效率。RankMixer 将主体计算组织为固定的信息重排和独立的前馈网络,使主要计算集中到规则的矩阵乘法。
2 从原始特征到输入矩阵
2.1 符号与维度
下表采用模型章节的符号。向量按行向量参与乘法,矩阵的行表示 Token,列表示向量坐标。
| 符号 |
含义 |
维度或范围 |
| N |
语义特征组数量 |
用户、内容、序列和交叉特征等分组 |
| ei |
第 i 组的特征向量 |
不同组可以具有不同长度 |
| einput |
各组依次拼接的输入 |
[e1;e2;…;eN] |
| d |
投影前每段输入的长度 |
输入切片使用的维度 |
| T |
输入 Token 数量 |
与字段数量分别定义 |
| D |
投影后的模型维度 |
每个 Token 的长度 |
| H |
每个 Token 的 Head 数量 |
采用 H=T,且 D 能被 H 整除 |
| L |
RankMixer Block 数量 |
依次执行 L 层 |
| k |
FFN 中间维度的扩展比例 |
中间向量长度为 kD |
| Xn |
第 n 层输出 |
RT×D |
| Sn−1 |
第 n 层第一次归一化的输出 |
RT×D |
2.2 Embedding 怎样把类别编号变成向量
Embedding(可训练的向量表示)为每个类别保存一行参数。以用户 ID 为例,设用户数量为 V,向量长度为 de。对应的参数表为 Euser∈RV×de。查询用户 c 时,直接读取第 c 行:
euser(c)=Euser[c,:].
如果 qc 是只有第 c 个位置为 1 的 one-hot(独热)向量,同一操作也可以写成 qc⊤Euser。实际计算通常直接查询参数表,省去生成完整 one-hot 向量的成本。
类别编号只负责找到参数所在的位置。用户 253 和用户 254 是否兴趣相近,需要从训练反馈中学习。两行向量的数值没有“相邻编号应当相近”的限制。电影 ID 使用自己的参数表,用户表和电影表的同一行也分别更新。
训练时,一条样本只访问少量编号。相应的梯度主要更新被查询的行。热门编号拥有更多训练机会,低频编号获得的反馈更少。这解释了推荐系统为何同时关心 Embedding 容量、访问次数和低频特征的学习质量。
年龄、时刻和统计计数等数值特征,可以先进行尺度处理,再通过线性层或 MLP(多层感知机)形成向量。类别特征与数值特征经过各自编码,才进入后面的拼接。这里的编码方法说明输入向量如何产生;工业模型使用的完整字段处理规则仍由具体输入设置决定。
2.3 历史行为怎样进入主体网络
行为序列通常包含多次观看、点击或购买。假设每条行为经过编码后得到 bm,一个简单的序列表示是平均池化 es=M−1∑m=1Mbm。它保留整体兴趣,但平均操作会弱化行为顺序和候选内容之间的差异。
需要考虑当前候选时,可以计算每条行为与候选的相关分数,再按权重汇总。作为方法说明,可写成:
αm=∑r=1Mexp(ar)exp(am),es=m=1∑Mαmbm.
这里 am 可以由行为向量、候选向量和时间信息共同计算。分数越高,该行为在汇总中的权重越大。权重通过最终预测损失训练,因此“相关”指有助于目标预测的关系。
这两种计算用于理解 Sequence Module 的职责。RankMixer 的模型说明将该模块输出作为输入来源,未规定它必须采用其中某一种。M 描述历史行为数量,T 描述主体网络的 Token 数量。数百条行为可以形成一个序列向量,再进入一个或多个 Token。
2.4 为什么按语义组织输入
Feature Tokenization(特征分组与向量转换)决定模型如何组织特征。把每个字段单独设为一个 Token,可能产生数百个 Token。每个 Token 对应的计算较小,重要字段也可能分配不到足够的模型容量。把全部特征设为一个 Token,则会使结构成为普通的多层 DNN(深度神经网络)。
语义分组为这些特征提供组织方式。例如,把用户资料放在相邻位置,把候选内容的属性放在相邻位置,再安排历史行为和用户与内容的交叉信息。各组内部经过编码后,得到 e1,e2,…,eN。
拼接向量为:
einput=[e1;e2;…;eN].
随后按固定长度 d 切片,再投影到 D 维[1]:
xi=Proj(einput[d(i−1):di]),i=1,…,T.(2)
方括号采用左闭右开的切片含义。第一个切片取前 d 个坐标,第二个切片取后面的 d 个坐标。若投影采用线性层,可以写成:
xi=einput[d(i−1):di]Wproj+bproj,Wproj∈Rd×D.
这一步解释了 d 与 D 的区别:输入段长由 d 指定,后续网络宽度由 D 指定。两个数值可以相同,也可以不同。N 表示语义组数量,T 表示切片后的 Token 数量。一组较长的特征可以形成多个 Token。
特征排列需要与切片规则一起考虑。只按固定长度切片,边界可能经过某个语义组的中间。公式给出了连续切片方法,具体的组长度、补齐方式、余数处理和投影参数共享方式没有完整公开。理解结构时,可以确定每段投影后的维度;复现工业输入时,还需要这些设置。
这种排列给模型提供了学习前的结构安排。用户资料、内容属性和序列表示在固定位置进入网络,后面的独立 FFN 可以长期处理对应位置的信息。训练不会自动重新排列这些字段,因此改变字段顺序也会改变它们进入各个参数组的方式。
投影还让不同来源进入相同长度的表示。原始用户组可以有 64 个坐标,内容组可以有 128 个坐标;后面的重排与残差计算都需要确定的 D 维形状。向量长度相同只保证运算能够连接,表示中的有效关系仍要通过训练学习。
将所有 xi 按行排列,得到:
X0=x1x2⋮xT∈RT×D.
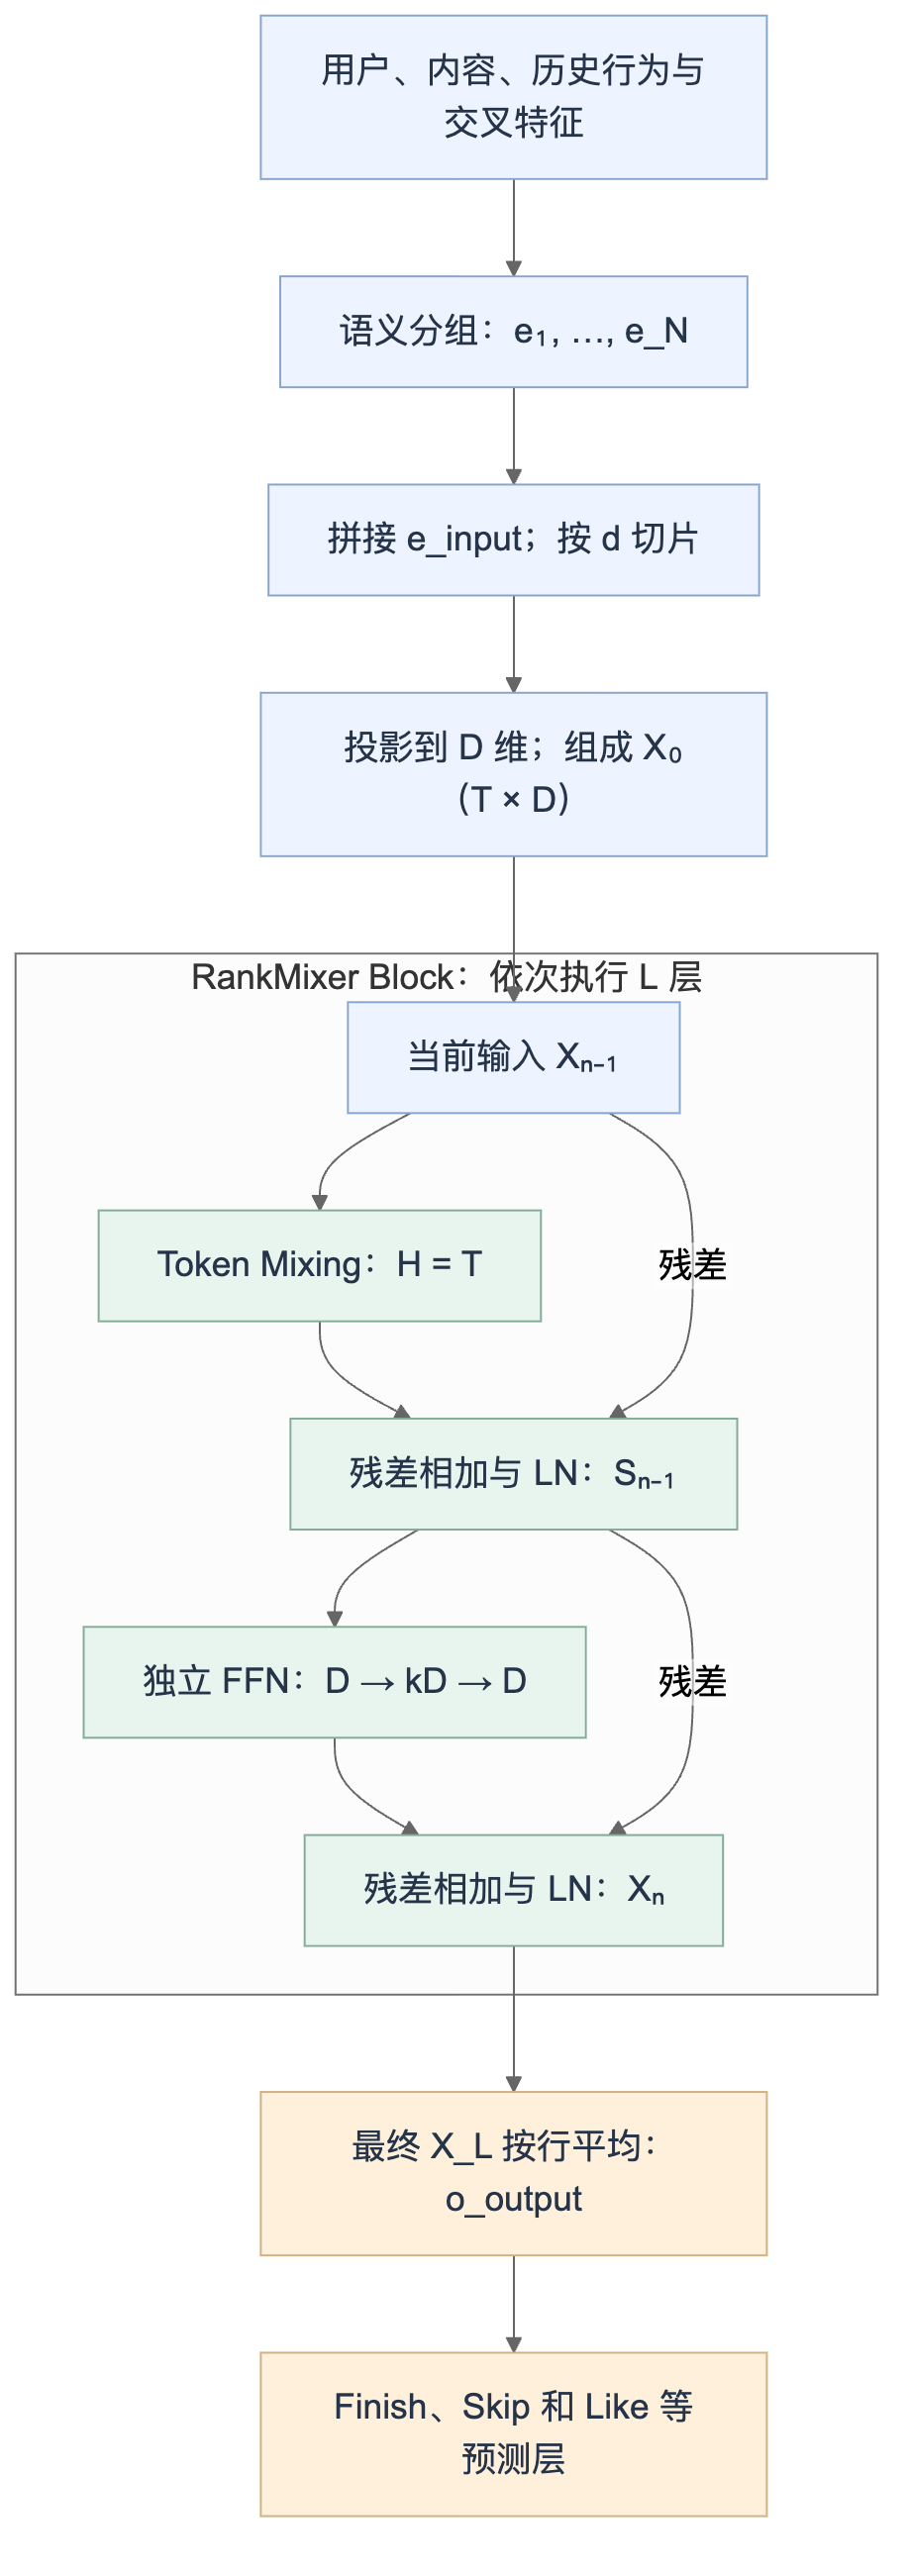 特征输入、RankMixer Block 与预测路径
图示根据公式(1)~(9)绘制,展示输入组织与两条残差路径[1]。
3 一个 RankMixer Block 的计算
每层包含两次残差连接和两次 LayerNorm(层归一化)。第 n 层接收 Xn−1,依次计算[1]:
Sn−1Xn=LN(TokenMixing(Xn−1)+Xn−1),=LN(PFFN(Sn−1)+Sn−1).(1)
下标 Sn−1 表示第 n 层中的中间矩阵。第一层的输入、中间结果和输出分别为 X0、S0 和 X1。
两次 LN 都发生在残差相加之后。运算次序为“子模块计算、残差相加、归一化”。把归一化移动到子模块之前,会改变网络的计算。
3.1 Multi-Head Token Mixing 怎样交换信息
每个输入 Token 均分为 H 个 Head:
[xt(1)∥xt(2)∥⋯∥xt(H)]=SplitHead(xt),xt(h)∈RD/H.(3)
∥ 表示向量拼接。这里的 Head 是连续坐标块。分组操作保持数值,也保持每个块内部的坐标顺序。每个块所表示的信息,会通过前面的投影和后面的训练形成。
随后收集所有输入 Token 的第 h 个 Head,组成一个新的混合 Token:
sh=Concat(x1(h),x2(h),…,xT(h)).(4)
因此,输出有 H 行,每行具有 TD/H 个坐标:
TokenMixing(X)∈RH×(TD/H).
残差相加要求它与 X∈RT×D 具有相同形状。设置 H=T 后,输出形状恢复为 T×D。同时,D/H 必须为整数。
把 q=D/H 作为局部记号,重排的坐标关系为:
[TokenMixing(X)]h,(t−1)q+r=Xt,(h−1)q+r,r=1,…,q.
可以将输入看成 T×H×q 的数组,交换前两个维度,再合并后两个维度。移动的是坐标块。只有在 D=H=T、每个 Head 长度为 1 时,结果才等于普通二维矩阵转置。
同一编号的 Head 来自各个 Token 的相同坐标区间。这些区间中的信息由投影参数逐步学习。可以把它理解为给后面的 FFN 安排一个固定的共同输入位置:各个来源都要向这个位置提供一部分表示。
例如,设置 T=H=4,D=8。每个 Head 长度为 2,新的第一行收集四个来源的前两个坐标。这个 FFN 就能共同处理来自用户、资料、内容和场景的四组信息。第二行则共同处理各个来源的第 3、4 个坐标。训练能够让不同区间形成不同用途。
下面的组件用连续编号表示坐标。选择每个 Head 含有两个坐标的配置,点击输出数字,就能查看对应的输入位置。
3.2 信息混合后为何还要保留输入
重排后的第 h 行含有全部来源的第 h 个 Head。残差路径则保留原来第 h 行的整个向量。两者相加,使后续 FFN 同时接收跨 Token 信息和当前行的信息:
(s1,…,sT)=LN(TokenMixing(x1,…,xT)+(x1,…,xT)).(5)
公式(4)和公式(5)使用了同一组 sh 符号。公式(4)表示刚完成重排的向量;公式(5)表示相加和归一化后的向量。理解整个 Block 时,以 Sn−1 表示后者,能够明确 FFN 接收哪个阶段的结果。
无参数重排给出了固定的信息交换路径。对于任意一个混合行,它只接收每个来源的一个 Head。残差又加入一个完整来源向量。后面的 FFN 可以在这些坐标之间进行学习;多层计算进一步改变并交换表示。
残差连接还提供直接的梯度路径。FFN 的输出变化可以通过一条路径影响输入,输入自身也通过相加参与输出。后续训练因此能够同时调整新增变换与已有表示的作用。
需要区分重排与残差相加各自保留的信息。重排保持全部坐标,具有逆置换;相加会合并两条路径的数值。例如,当 D=H=T 时,相加得到 X+X⊤。位置 (1,2) 和 (2,1) 的原值若为 2 和 5,两处相加后都是 7。原值换为 3 和 4,相加结果仍相同。
因此,重排可逆不能直接推广到整个 Block。残差相加与 LN 都会改变信息的表达。这个结构提供的是特定的交互方式,其预测价值需要结合完整网络和消融结果判断。
3.3 LayerNorm 在哪里计算平均值
LN 对每个 Token 的 D 个坐标分别计算平均值和方差[2]。设一行输入为 r∈RD:
μ=D1j=1∑Drj,σ2=D1j=1∑D(rj−μ)2.
归一化输出为:
LN(r)j=γjσ2+εrj−μ+βj.
γj 和 βj 是可以学习的缩放与平移参数。ε 用于维持分母的数值稳定。方差公式除以 D,与计算样本方差时除以 D−1 的方式分别定义。
各行分别归一化,平均值和方差也各自计算。Batch(批次)中其他样本的数值不参与这一行的统计。这样,同一个请求的计算可以独立完成。
归一化帮助控制表示的数值尺度。训练后的 γ 和 β 会继续改变输出,因此均值为 0、方差接近 1 的描述,适用于仿射变换前的归一化结果。
LN 保留的是当前行中各个坐标相对平均值的位置。对这一行的全部坐标增加同一个常数,减去均值后的结果保持不变。乘以同一个正常数时,标准差也相应增大;在 ε 很小时,归一化结果近似保持不变[2]。
这使后续 FFN 更容易处理来源不同、幅度不同的表示。代价是该行共同的平移与尺度信息被归一化处理。可训练的 γ 和 β 提供新的缩放与平移,但不能原样恢复每条输入已经去除的均值。
例如,两行输入分别为 [1,2,3,4] 和 [11,12,13,14]。它们减去各自均值后,都得到 [−1.5,−0.5,0.5,1.5]。这说明 LN 强调坐标之间的关系,也说明绝对数值若与任务有关,需要由整个输入与网络设计承载。
3.4 Self-Attention 如何学习信息汇总权重
Self-Attention 是理解路由对照实验需要掌握的方法[3]。以单个 Head 为例,先对 X∈RT×D 进行三种投影:
Q=XWQ,K=XWK,V=XWV.
Q 表示当前行查询什么信息,K 表示各个来源提供怎样的匹配信息,V 表示实际参与汇总的向量。若查询与键的长度为 da,输出为:
Attention(X)=softmax(daQK⊤)V.
QK⊤ 的形状是 T×T。第 i 行列出第 i 个 Token 对全部来源的分数。softmax(指数归一化)沿这一行计算,使权重之和为 1。若用户 Token 与某个内容 Token 的投影匹配较强,该内容向量就获得更大的汇总权重。
分母 da 用于控制内积分数的尺度。假设查询与键的各个坐标独立、均值为 0、方差为 1,内积的方差约为 da。经过缩放后,方差约为 1,能够减轻过大的分数使 softmax 过度集中的问题[3]。
Attention 在每条样本上重新计算汇总权重。异构特征是否能够有效匹配,取决于输入编码和投影训练。Multi-Head Token Mixing 则提供固定的坐标交换路径,让后续 FFN 学习组合响应。
计算成本也来自不同位置。单个 Attention Head 的分数与汇总乘法约为 O(T2da),投影还需要额外乘法。Token Mixing 的坐标重排约为 O(TD),主要学习计算由 PFFN 的 O(kTD2) 承担。实际延迟还受到矩阵形状和数据读取的影响。
4 Per-token FFN 如何学习交互关系
4.1 每个 Token 使用自己的参数
FFN(Feed-Forward Network,前馈网络)接收一个 D 维 Token,将它映射到 kD 维,经过 GELU 激活,再映射回 D 维[1]:
vt=fpffnt,2(Gelu(fpffnt,1(st))).(6)
两个线性层分别为:
fpffnt,i(x)=xWpffnt,i+bpffnt,i.(7)
参数的维度为:
Wpffnt,1Wpffnt,2∈RD×kD,∈RkD×D,bpffnt,1bpffnt,2∈RkD,∈RD.
上标 t 表示 Token 对应的参数组。不同 Token 使用不同的矩阵和 bias(平移参数)。同一个 Token 位置在不同样本之间共享这一组参数;这些参数也在训练期间持续更新。
可以把单个 FFN 展开为:
utatvt=stWpffnt,1+bpffnt,1,=Gelu(ut),=atWpffnt,2+bpffnt,2.
GELU(Gaussian Error Linear Unit,高斯误差线性单元)的定义是[4]:
Gelu(u)=uΦ(u),
其中 Φ 是标准正态分布的累积分布函数。负数输入可以得到较小的负数输出,正数输入也经过连续的调整。激活逐个坐标执行。
GELU 可以借助概率门理解。给定输入 u,假设一个取值为 0 或 1 的门 B,取值为 1 的概率为 Φ(u)。则 uB 的期望为 uΦ(u)。网络实际执行的是这个确定的函数,计算时不需要随机采样[4]。
输入为 1 时,GELU 约为 0.8413;输入为 -1 时,约为 -0.1587。较大的正数接近完整通过,较大的负数接近 0。中间范围连续变化,因此隐藏单元能对特征组合的强弱产生平滑响应。
把全部独立 FFN 的输出排列起来,得到:
(v1,…,vT)=PFFN(s1,…,sT).(8)
这一步的合写形式为:
PFFN(s1,…,sT)=fpffnt,2(Gelu(fpffnt,1(s1,…,sT))).(9)
这里的 fpffnt,i 表示按 Token 位置选择参数的并行变换。每个 t 对应自己的 Wt,1 和 Wt,2。PFFN 是 T 个独立网络的并行计算。
4.2 固定重排怎样产生可学习的特征交互
第 t 个 FFN 的一个中间坐标为:
ut,j=r=1∑Dst,rWpffn,rjt,1+bpffn,jt,1.
经过重排和残差相加,st 的坐标已经包含多个特征来源。这个加权和就能共同使用这些信息,GELU 再让输出对信息组合产生非线性响应。
例如,用户兴趣的一部分和候选内容的一部分进入同一行后,FFN 的隐藏单元可以根据二者共同变化。输出矩阵 Xn 随后又进入下一层的信息交换。这样,固定路径负责组织信息,参数负责学习信息之间的关系。
用一个隐藏单元可以进一步看到交互从哪里产生。设两个来源经过权重后,分别贡献 q1 和 q2,忽略该单元的平移参数。激活前的数值为 q1+q2。考察两者共同出现时增加的响应:
C=Gelu(q1+q2)−Gelu(q1)−Gelu(q2)+Gelu(0).
当 q1=q2=1 时,C≈0.2718。两个来源共同出现,产生了两个单独响应之外的变化。训练可以调整权重,使不同来源的组合触发不同隐藏单元;第二个线性层再汇总这些单元。
这个例子解释的是非线性组合响应。FFN 中还有更多坐标、隐藏单元和可训练参数。将“存在交互”直接解释成某个固定的多项式阶数,需要额外的数学条件。连续执行多个 Block,会让已经包含交互的信息继续参与下一层计算。
独立参数也为各个位置提供了不同的计算能力。初始 Token 按语义组织,混合之后的行已经接收其他来源的信息。此时每个 FFN 建模的是对应位置的组合表示。
Self-Attention(自注意力)通过样本相关的权重汇总 Token。RankMixer 的交换路径固定,样本相关的处理发生在投影、FFN 和后续预测中。这种设计的适用性由下篇中的路由对照和消融实验检验。
4.3 参数量增加为何可以保持 FFN 计算量
一个两层 FFN 的主要权重数量为:
D(kD)+(kD)D=2kD2.
共享 FFN 只有一组权重,但仍需要对 T 个输入分别执行乘法。独立 FFN 有 T 组权重,每个输入也只执行自己的两层乘法。固定 T,D,k,两种结构的主要乘法次数相同:
共享 FFN独立 FFN权重数量2kD22kTD2单层前向 FLOPs4kTD24kTD2
FLOPs(浮点运算次数)按一次乘法和一次加法各计一次。参数共享减少了需要保存的权重,重复处理 Token 的乘法仍然需要执行。独立参数则增加了存储容量。
这个比较固定了输入形状和网络宽度。随着 T、D 或 L 增大,Dense RankMixer 的计算量也随之增加。内存访问、并行组织和实际延迟,还需要运行环境中的测量。
Batch 能让独立参数得到重复使用。设批次包含 B 条样本,同一 Token 位置的输入组成 B×D 矩阵。这个矩阵与该位置的 D×kD 权重相乘,一次就能处理多条样本。不同 Token 位置再并行执行各自的矩阵乘法。
因此,“每个 Token 有独立参数”仍然允许跨样本复用参数。GPU 执行效率取决于这些矩阵是否足够大、任务是否能够共同调度,以及权重读取成本。公式说明乘法数量,硬件测量说明这些乘法执行得多快。
5 输出预测与梯度传播
5.1 从最后一层得到行为概率
执行 L 个 Block 后,对 XL 的各行取平均:
ooutput=T1t=1∑TXL[t,:]∈RD.
平均操作得到一个共享的请求与候选内容表示。完成观看、划走和点赞等任务,可以各自接预测层。主体结构给出了共享表示,任务预测层的全部结构和任务权重需要另外设置。
平均池化让输出长度固定为 D,不会随 Token 数量增长。各行在汇总时使用相同的系数,但各行此前经过不同的 FFN 和多次信息交换。不同特征对预测的影响,已经包含在这些可训练变换中。因此,平均系数相同也允许不同特征具有不同的预测作用。
为了解释二分类的后续计算,采用一个线性预测层:
z=ooutputw+b,p^=sigmoid(z)=1+e−z1.
z 称为 logit(概率变换前的分数)。p^ 是标签为 1 的预测概率。这个预测层用于下面的数据演示。
5.2 训练信号怎样到达固定重排之前
对于二分类标签 y∈{0,1},BCE(Binary Cross-Entropy,二元交叉熵)为:
ℓ=−ylogp^−(1−y)log(1−p^).
求导时,BCE 对概率的导数为 (p^−y)/(p^(1−p^))。sigmoid 对 z 的导数为 p^(1−p^)。两者通过链式法则相乘,得到:
∂z∂ℓ=p^−y.
标签为 1 时,p^−y 为负,梯度下降会推动当前样本的 logit 增大。标签为 0 时,该导数为正,更新方向会推动 logit 减小。这个反馈继续传到 FFN、投影和 Embedding,各个样本共同决定共享参数的更新方向。
平均池化再把预测层收到的梯度平均分给各行。若 go=∂ℓ/∂ooutput,则:
∂XL[t,:]∂ℓ=T1go.
在 FFN 内部,第二个线性层把梯度继续送回 GELU 和第一个线性层。设 gvt 是 FFN 输出收到的行向量梯度,采用前面定义的 ut 和 at:
gatgutgstFFN=gvt(Wpffnt,2)⊤,=gat⊙Gelu′(ut),=gut(Wpffnt,1)⊤.
⊙ 表示对应坐标相乘。精确 GELU 的导数是 Φ(u)+uϕ(u),其中 ϕ 为标准正态密度。两个矩阵收到的梯度为:
∂Wpffnt,2∂ℓ∂Wpffnt,1∂ℓ=at⊤gvt,=st⊤gut,∂bpffnt,2∂ℓ∂bpffnt,1∂ℓ=gvt,=gut.
这些式子描述单条样本。批次中的梯度按损失的汇总方式相加或平均。各个 Token 更新自己的 FFN 参数,输入还会收到残差路径直接传来的梯度。
LN 的梯度同时受到当前行全部坐标的影响。设 r^j=(rj−μ)/σ2+ε,LN 输出收到 gj,令 qj=gjγj。则输入梯度为:
∂rj∂ℓ=σ2+εqj−mean(q)−r^jmean(q⊙r^).
均值与方差使用了当前行的全部坐标,所以每个输入坐标的梯度也包含这些共同统计。可训练仿射参数的单条样本梯度为 ∂ℓ/∂γj=gjr^j 和 ∂ℓ/∂βj=gj。
Token Mixing 继续把梯度送回输入坐标。设 vec(X) 表示把所有坐标排列为一个长向量。固定重排可以写成置换矩阵 P:
vec(TokenMixing(X))=Pvec(X).
如果重排输出收到梯度 g,输入收到 P⊤g。它将梯度送回对应的原坐标。P⊤P=I,所以这条路径可以恢复完整的坐标对应关系。
在第一次 LN 之前,残差相加的导数还包含原输入路径:
∂vec(X)∂ℓ=(P⊤+I)g.
这里的 g 是通过 LN 反向计算之后的梯度。随后,梯度继续到达输入投影和特征 Embedding(编号对应的可训练向量)。重排自身没有参数,前后的可训练模块仍能通过这一计算链学习。
6 用 MovieLens 样本核对完整流程
6.1 样本与计算设置
MovieLens 100K 包含 943 个用户、1,682 部电影和 100,000 条评分。字段说明见 GroupLens 数据说明[5]。选择用户 253 对电影 465 的评分记录,评分为 5,Unix 时间戳为 891,628,467。用户年龄为 26,性别为女性。
演示定义 y=1[r≥4],所以该记录的标签为 1。需要预测的是已评分记录的高评分概率。输入使用用户 ID、年龄与性别、电影 ID 和评分时间的编码。
计算设置为 T=H=D=4、L=1、k=2。四个 Token 对应用户、资料、电影和时间。年龄除以 100,性别编码为 1;时间编码使用 UTC 小时除以 23、星期序号除以 6。
数值由 PyTorch 2.10.0、随机种子 7 的初始化计算得到。原始字段来自真实记录,中间矩阵来自尚未训练的模型。LN 使用 ε=10−5,初始 γ=1,β=0。下列矩阵保留四位小数,组件中使用完整精度。
这一演示分别投影四组字段,用于核对 Block 运算。工业模型的输入分组和统一切片需要采用前面的公式(2)及其具体配置。
6.2 输入、重排与第一次 LN
特征编码得到:
X0≈0.2511−0.76460.11670.06310.67160.48440.27080.71230.1599−0.89431.0803−0.18011.17650.53171.39090.8389.
每个 Head 只有一个坐标,重排在这里等于 X0⊤。第一条残差相加得到:
X0+TokenMixing(X0)≈0.5022−0.09290.27661.2396−0.09290.9689−0.62351.24400.2766−0.62352.16051.21081.23961.24401.21081.6778.
第一行的均值约为 0.4814,方差约为 0.2368。第一个坐标的归一化结果为:
0.2368+10−50.5022−0.4814≈0.0428.
逐行计算得到:
S0≈0.0428−0.6128−0.4618−0.5340−1.18020.7803−1.3287−0.5113−0.4208−1.30881.3526−0.68281.55821.14130.43791.7281.
6.3 独立 FFN 与第二次 LN
每一行使用自己的 4→8→4 网络。第一行经过第一个线性层后,得到:
u1≈[−0.09510.2896−0.33450.3215−0.24250.33420.4754−0.2541]flatten.
此处用两行排版展示一个 8 维向量,坐标顺序按行读取。经过 GELU 后,它的第一个坐标约为 -0.0439,第四个坐标约为 0.3246。第二个线性层将 8 个坐标共同映射为 4 个坐标。
四个 FFN 的输出为:
V=PFFN(S0)≈0.06820.08340.04280.0886−0.08560.0034−0.0371−0.0460−0.1294−0.1546−0.0404−0.07800.08600.08090.0224−0.0453.
第二条残差计算 S0+V,随后逐行归一化:
X1=LN(S0+V)≈0.1174−0.5005−0.4173−0.4297−1.16370.7334−1.3670−0.5427−0.4978−1.37831.3194−0.74831.54411.14540.46491.7207.
6.4 池化、预测与一条样本的损失
将 X1 的四行取平均:
ooutput≈[−0.3075,−0.5850,−0.3262,1.2188].
预测层的初始化参数为:
w≈[0.3031,0.4582,0.2000,0.4263]⊤,b≈0.2727.
代入完整精度的数值,得到:
z≈0.365762,p^≈0.590435,ℓ=−logp^≈0.526896.
该样本的 y=1,所以:
∂z∂ℓ≈−0.409565.
梯度下降会沿着提高该样本 logit 的方向更新预测层,并继续更新前面的模块。若训练采用批次平均损失,每条样本传来的梯度还需要除以批次中的样本数量。
下面的组件保存了各阶段矩阵。依次选择输入、混合、第一次 LN、FFN、第二次 LN 和池化,即可核对上述数值。组件中的 X、S、Z 和 o,分别对应 X0、S0、X1 和 ooutput。
专家路由、模型规模和工业实验,继续见 RankMixer 详解(2):Sparse MoE、规模扩展与实验设计。
7 参考文献
- Jie Zhu、Zhifang Fan、Xiaoxie Zhu 等。2025。RankMixer: Scaling Up Ranking Models in Industrial Recommenders。arXiv:2507.15551v3。
- Jimmy Lei Ba、Jamie Ryan Kiros、Geoffrey E. Hinton。2016。Layer Normalization。arXiv:1607.06450。
- Ashish Vaswani、Noam Shazeer、Niki Parmar 等。2017。Attention Is All You Need。NeurIPS 2017。
- Dan Hendrycks、Kevin Gimpel。2016。Gaussian Error Linear Units (GELUs)。arXiv:1606.08415。
- GroupLens Research。1998。MovieLens 100K Dataset README。
评论由 GitHub Giscus 提供。若当前网络无法加载,可 前往 GitHub Discussions 查看或参与讨论。